
PDF 转 Markdown:LiteParse 9 月更新改变了什么
LiteParse 2.14.6 将 PDF 文本提取耗时缩短 20–25%,三个基准的表格准确率全面提升,并新增块级视觉定位与 is-complex 路由 API。解读这些厂商自报数据,并给出如何选择 PDF 转 Markdown 方案的决策标准。
9 月 22 日,LlamaIndex 发布了对 LiteParse 的一次重要更新——这是一款今年早些时候上线的无模型开源 PDF 解析库,而这次更新直接改变了 PDF 转 Markdown 这件事的成本账。2.14.6 版本把 PDFium 提取文本的耗时砍掉了 20–25%,在项目维护的全部三个基准上提升了表格识别准确率,新增了块级视觉定位(block + bounding box),还引入了一个名为 is-complex 的 API,让你在解析之前就能识别出难啃的文档。在关闭 OCR 的条件下,文本提取平均耗时降到每页 2.8 毫秒,完整 Markdown 渲染每页 3.9 毫秒——本地开源解析器不再是慢的那一个,同时这次发布对自身的能力边界也说得异常坦率。
核心要点
- LiteParse 2.14.6 的文本提取比 2.1 快约 20–25%,这来自对项目自维护 PDFium fork 的深度优化。厂商实测:每页 2.76 毫秒对 3.51 毫秒,同一批文档上 pypdf 是 35.78 毫秒。
- 同一基准下,完整 Markdown 渲染为每页 3.94 毫秒——是对比列表中第二名工具速度的 1.5 倍,是 pymupdf4llm 或 markitdown 的 35 倍以上。
- 三个基准上的表格提取全部提升;opendataloader-bench 上的表格结构得分(TEDS)从 0.693 涨到 0.818。
- Markdown 元素现在可以连同边界框一起导出为块对象,每段输出都能回溯到原页面上的具体区域。
- 新的
is-complexAPI(每页约 3.5 毫秒)会告诉你哪些文档需要交给更强的、带模型的解析管线。
提速 20–25% 背后的 PDFium 手术
LiteParse 是无模型解析器,速度来自 Google 维护的 PDF 库 PDFium——而 LiteParse 团队维护着自己的 fork。正是这种所有权让这次更新成为可能。性能分析显示,两个函数——FPDF_LoadPage 和 FPDFText_LoadPage——占了总运行时间的一半以上,而这些时间消耗在海量的小内存分配上。
最值得关注的一处修复发生在分配器层面:团队把 mimalloc 直接编译进了 fork,但只替换了 PDFium 自己的分配通道。libc 的 malloc 原封不动——这一点对把 LiteParse 嵌入 Node 或 Python 进程的人很重要:你的宿主进程继续用自己的分配器,只有解析引擎换上了更快的那个。其余优化包括:字体宽度、字符码等热路径上的缓存与记忆化,修复了空格折叠中的二次复杂度,以及在列表上更早地释放内存。
在 LlamaIndex 自己的一组真实 PDF 上(关闭 OCR),实测结果如下:
| 工具 | 文本提取(毫秒/页) |
|---|---|
| LiteParse 2.14.6 | 2.76 |
| LiteParse 2.1 | 3.51 |
| pypdf | 35.78 |
完整 Markdown 渲染与其他转换工具的差距更大:
| 工具 | Markdown 渲染(毫秒/页) | 对比 LiteParse |
|---|---|---|
| LiteParse 2.14.6 | 3.94 | 1.0× |
| pdf-inspector 1.19 | 5.72 | 1.5× |
| opendataloader-pdf 2.5.7 | 24.15 | 6.1× |
| pymupdf4llm 1.28.2 | 140.80 | 35.7× |
| markitdown 0.1.7 | 191.07 | 48.5× |
发布说明里有一句值得注意的实话:2.1 以来 Markdown 准确率的提升带来了额外延迟,而这次 PDFium 的优化把时间赢了回来。渲染提速不是白来的——它是在更重的启发式逻辑之后算出来的净结果。
三个基准上的表格准确率全部上涨
如果只有速度,这次更新会显得单薄。发布同时报告了 LiteParse 追踪的每个基准上的准确率提升,全部在关闭 OCR 的条件下测得:
- opendataloader-bench(200 份文档):表格结构得分(TEDS)从 2.1 的 0.693 涨到 2.14.6 的 0.818,总分从 0.875 涨到 0.886。值得注意的是,这个 TEDS 成绩已经超过对比中的商业引擎(nutrient,0.708),不过阅读顺序(NID)仍然是 nutrient 领先(0.925 对 0.917)——这是进步,但不是横扫。
- olmOCR-bench(1,403 页):表格测试从 48.2 提升到 52.5,总分从 39.1 到 39.6。
- ParseBench(2,049 份文档):总分 0.364,视觉定位得分翻了一倍多(0.108 到 0.297)。ParseBench 在上篇发布后更换过评分器,所以团队把 2.1 放到当前评分器下重跑了一遍,而不是拿旧数字去对一把新尺子——这是正确的做法。
底层来看,准确率工作集中在:绘制出来的分隔线(rule-line)的纳入、分栏检测、多行表头处理,以及多语言文档中从右到左与从左到右文本的区分。延迟方面的对冲则来自边界框提取修复、密集页面的重叠检测改进,以及对页面截图尺寸的钳制。
视觉定位:能回溯到页面的 Markdown
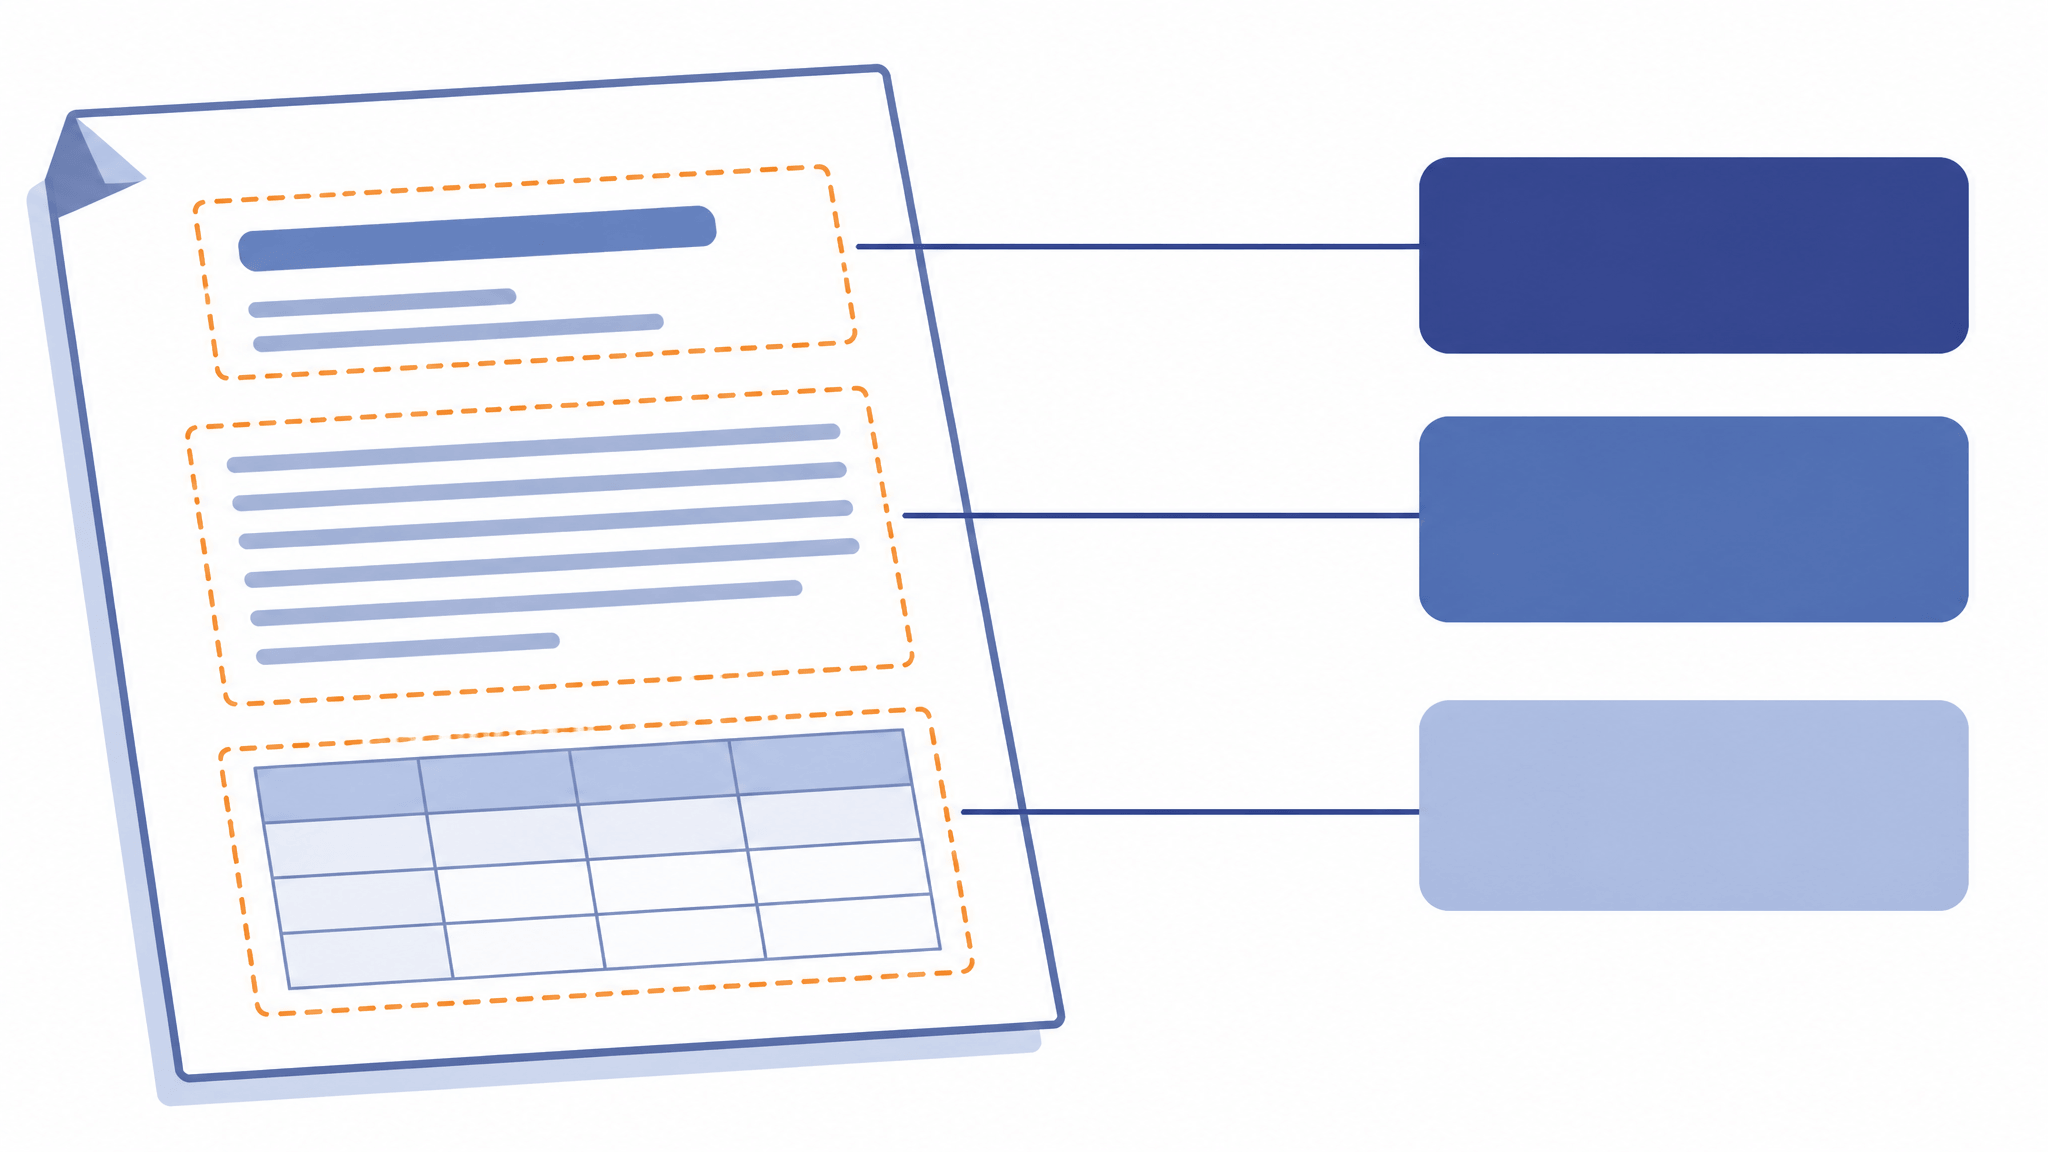
在此之前,LiteParse 输出的是一个 Markdown 字符串,你要么全收,要么放弃。这次更新提供了一个新选项:导出底层的块结构——每个 Markdown 元素(段落、标题等)都作为一个对象返回,附带文本、层级(如适用)和页面坐标系中的边界框。
这改变了下游能做的事情。RAG 管线可以引用答案来自哪一页的哪个区域;质检流程可以把提取出的标题对照原始扫描件高亮,及时发现误读;文档搜索产品可以让用户从一段 Markdown 摘要直接跳到页面上的确切位置。视觉定位把解析器的输出从一团文本变成了可寻址的结构。
is-complex:是路由器,不是裁判
第三个新增能力 is-complex 每页成本约 3.5 毫秒,它会报告一份文档会不会让无模型解析器为难:是否扫描件、字体或文本是否乱码、文本覆盖率,以及版面信号——比如疑似表格或多栏文本(用的是与 Markdown 渲染器同一套启发式)。
LlamaIndex 自己的表述很有参考价值:无模型解析器在复杂文档上"永远赢不了更高级的解析管线",因为管线里没有模型去理解混乱的版面。is-complex 的存在就是让你不必用失败去换这个认知——先跑一次便宜的检查,把被标记的文档路由给更强的管线(LlamaParse 是官方建议的升级路径),其余文档走快车道。复杂度指南给出了完整的输出结构。
如何选择你的 PDF 转 Markdown 方案
这次更新改变的是决策的权重,而不是决策本身。按任务匹配方案:
- 批量或嵌入式转换,数字原生 PDF。 本地开源解析现在是默认候选。LiteParse 2.14.6 提供每页毫秒级的提取速度,支持 Node、Python、Rust,甚至能通过 WASM 跑在浏览器里,采用 Apache-2.0 协议。如果你的文档是数字原生(不是扫描件),这次启发式准确率的提升足以让输出直接可用,不需要引入模型。
- 复杂版面、扫描件、高风险表格。 用
is-complex识别它们,然后路由给基于模型的管线。更快的启发式不改变复杂文档的天花板——那是另一类工具的领域。 - 偶尔转一个文件,不想装环境。 在线转换器对一次性的单个文档依然够用;用管线控制力换便利性。
- 解析之前,先检查内容来源。 有相当一部分"PDF"其实只是打印出来的网页。如果你的内容本来就在一个 URL 上,直接转换网页比解析它的 PDF 副本更快、更干净——URL to Any 的 URL to Markdown 工具在浏览器里就能把任何公开页面转成干净的 Markdown,免费、无需注册,也不碰你的本地文件。
值得知道的边界
本文的每一个数字都是厂商自报的:LlamaIndex 自己的基准、自己的文档集、关闭 OCR(开启 OCR 会带来小幅提升,尤其是配合 PaddleOCR 时)。"最快"是发布说明自己的说法,范围限于它测试过的开源解析器。采用数据——每周 30 万+ 下载、GitHub 12k+ star——同样来自官方公告。而启发式的天花板是真实存在的,这一点厂商自己也承认;这次更新移动的是速度线和表格准确率线,不是复杂度天花板。
结论
LiteParse 2.14.6 让本地 PDF 转 Markdown 在本已最快的地方又快了大约 20–25%,在表格准确率上取得了实质性进展,并补上了使用者对解析器真正在意的东西:输出可溯源,以及何时该升级的提前预警。如果 PDF 解析一直是你文档管线里又慢又不可靠的一环,9 月的这次更新给了你一个具体的理由,用自己的文档重新跑一遍它——并且在 is-complex 提示的时候,果断绕开它。
Related Articles
Qwen3.8-Omni-Flash 上线:把网页转成 Markdown/JSON 喂给多模态模型
Qwen3.8-Omni-Flash 支持文本、图像、音频、视频输入与 1M 上下文,每小时音频输入价格下降超 98%。什么时候把网页转成 Markdown、什么时候转 JSON?浏览器免费完成,无需安装。
Cloudflare「禁止 AI 训练」新规:网页转 Markdown 工作流要注意什么
Cloudflare 的 Disallow AI Training 设置把搜索收录与 AI 训练解耦。这次爬虫新政对网页转 Markdown 提取意味着什么,抓取工作流又该怎么调整。
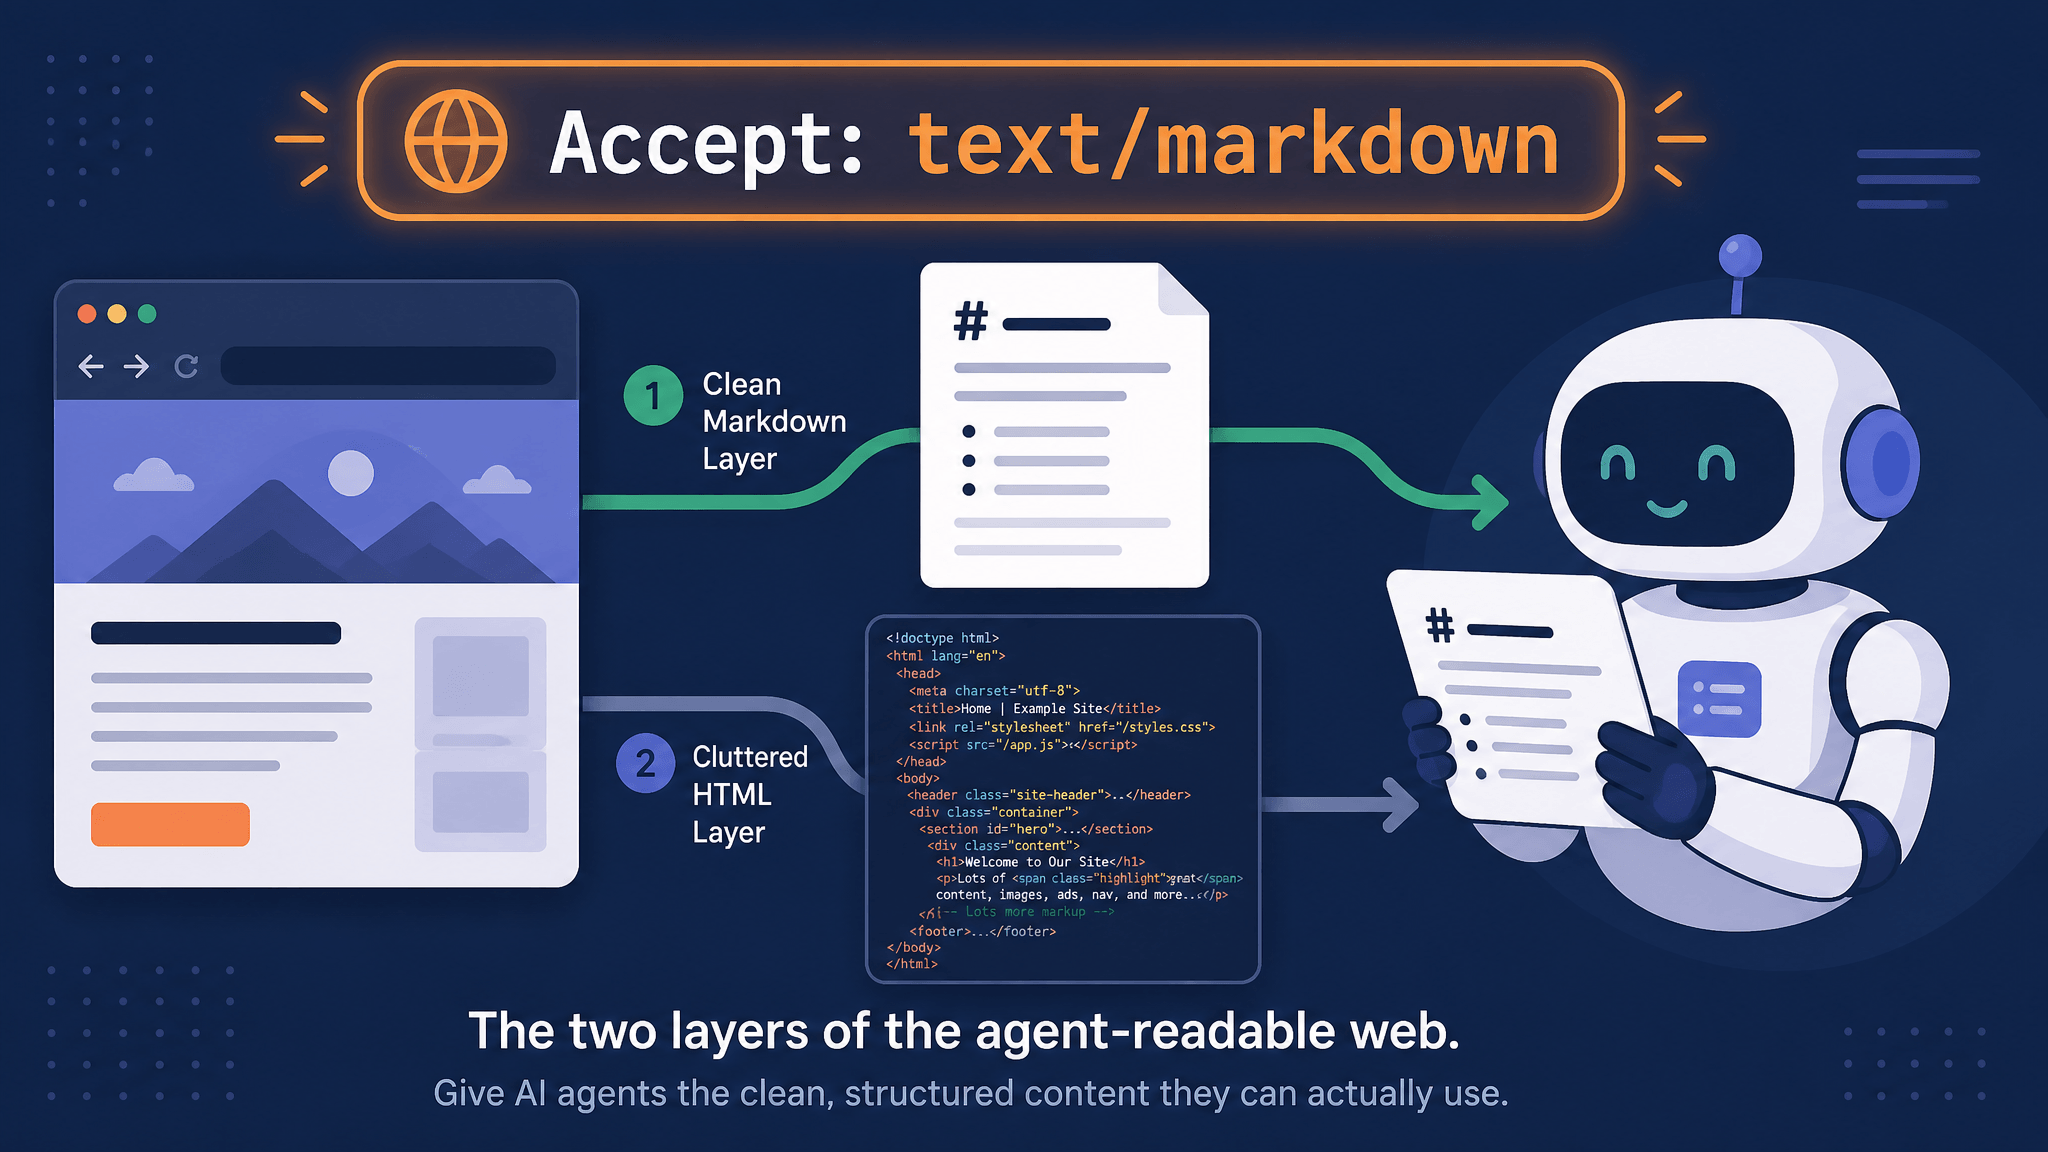
AI Agent 是怎么读网页的:Markdown 内容协商、WebMCP 与 10 秒自检
AI Agent 通过普通 HTTP 读取你的网页。讲清 Accept: text/markdown 内容协商的原理、哪些 Agent 真正支持、WebMCP 带来什么改变,以及如何 10 秒检查任意 URL。