
博客
关于 URL To Any 的新闻、资源和更新
PDF 转 Markdown:LiteParse 9 月更新改变了什么
LiteParse 2.14.6 将 PDF 文本提取耗时缩短 20–25%,三个基准的表格准确率全面提升,并新增块级视觉定位与 is-complex 路由 API。解读这些厂商自报数据,并给出如何选择 PDF 转 Markdown 方案的决策标准。
Qwen3.8-Omni-Flash 上线:把网页转成 Markdown/JSON 喂给多模态模型
Qwen3.8-Omni-Flash 支持文本、图像、音频、视频输入与 1M 上下文,每小时音频输入价格下降超 98%。什么时候把网页转成 Markdown、什么时候转 JSON?浏览器免费完成,无需安装。
Cloudflare「禁止 AI 训练」新规:网页转 Markdown 工作流要注意什么
Cloudflare 的 Disallow AI Training 设置把搜索收录与 AI 训练解耦。这次爬虫新政对网页转 Markdown 提取意味着什么,抓取工作流又该怎么调整。
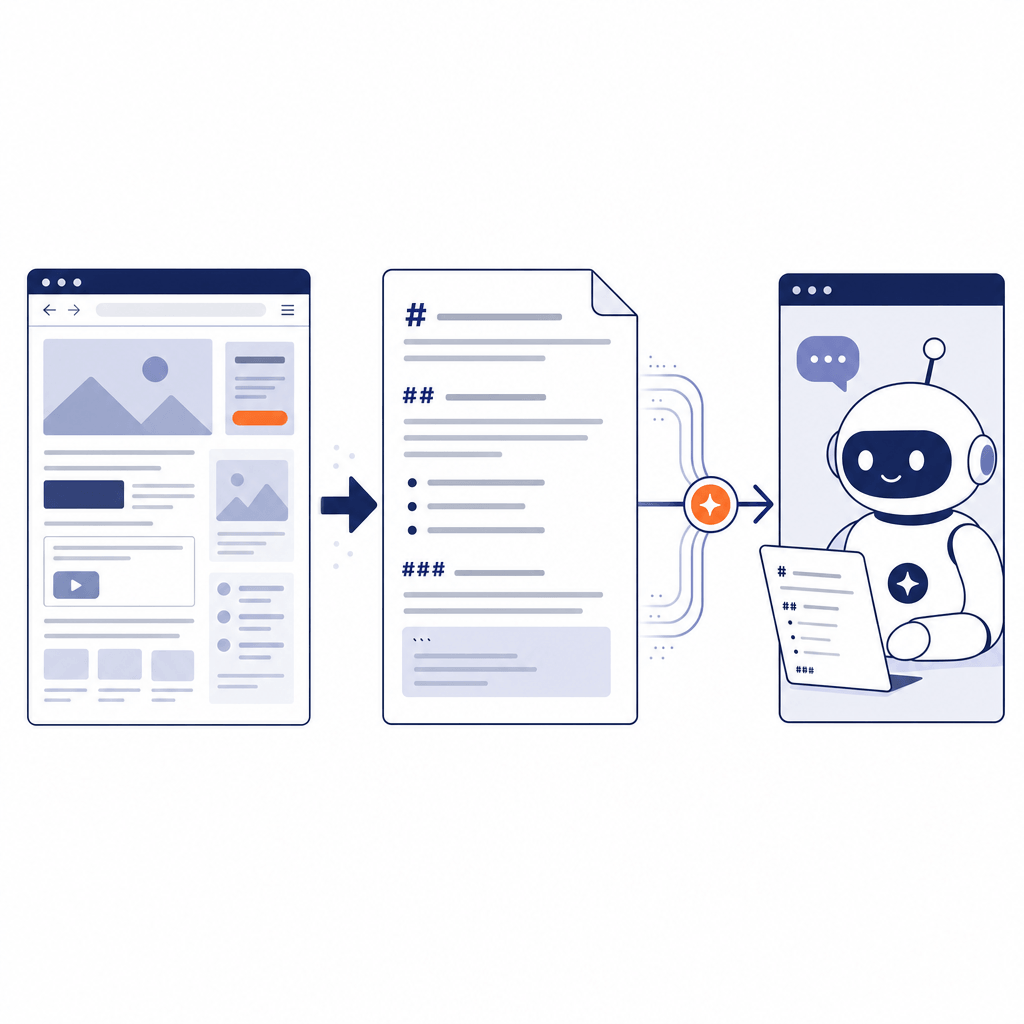
URL 转 Markdown:如何给 AI Agent 喂干净的网页内容
别再粘贴原始 HTML。这套一分钟 URL 转 Markdown 工作流让 AI Agent 读到干净的网页内容——并附上何时该让 Agent 直接浏览的判定规则。
AI 回答引擎如何选源:215,128 个批量页面的启示
新研究显示 AI 回答大量引用批量生成的"best software"页面。解析 AI 回答引擎如何选源,以及如何让真实内容可提取、可引用。
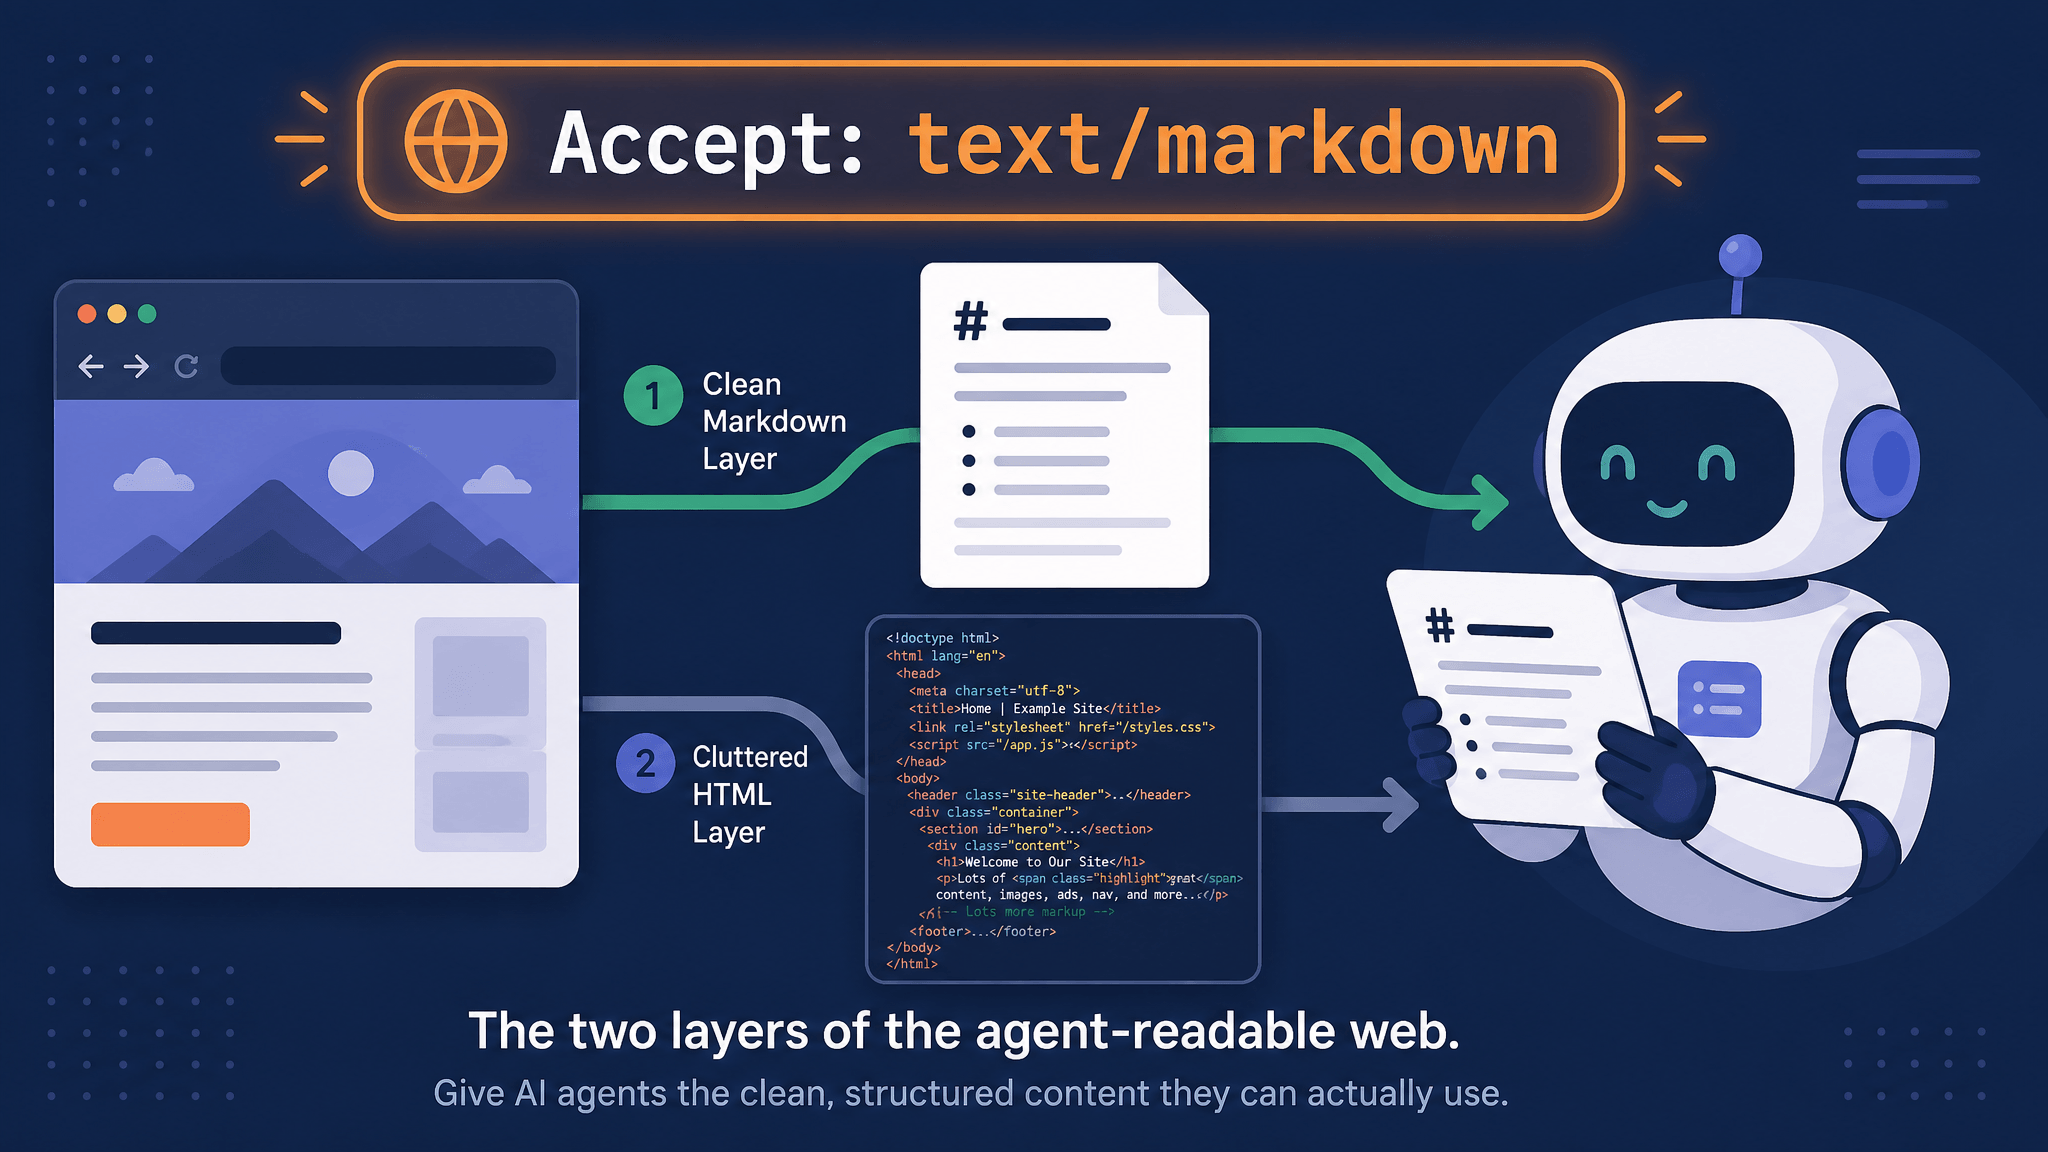
AI Agent 是怎么读网页的:Markdown 内容协商、WebMCP 与 10 秒自检
AI Agent 通过普通 HTTP 读取你的网页。讲清 Accept: text/markdown 内容协商的原理、哪些 Agent 真正支持、WebMCP 带来什么改变,以及如何 10 秒检查任意 URL。
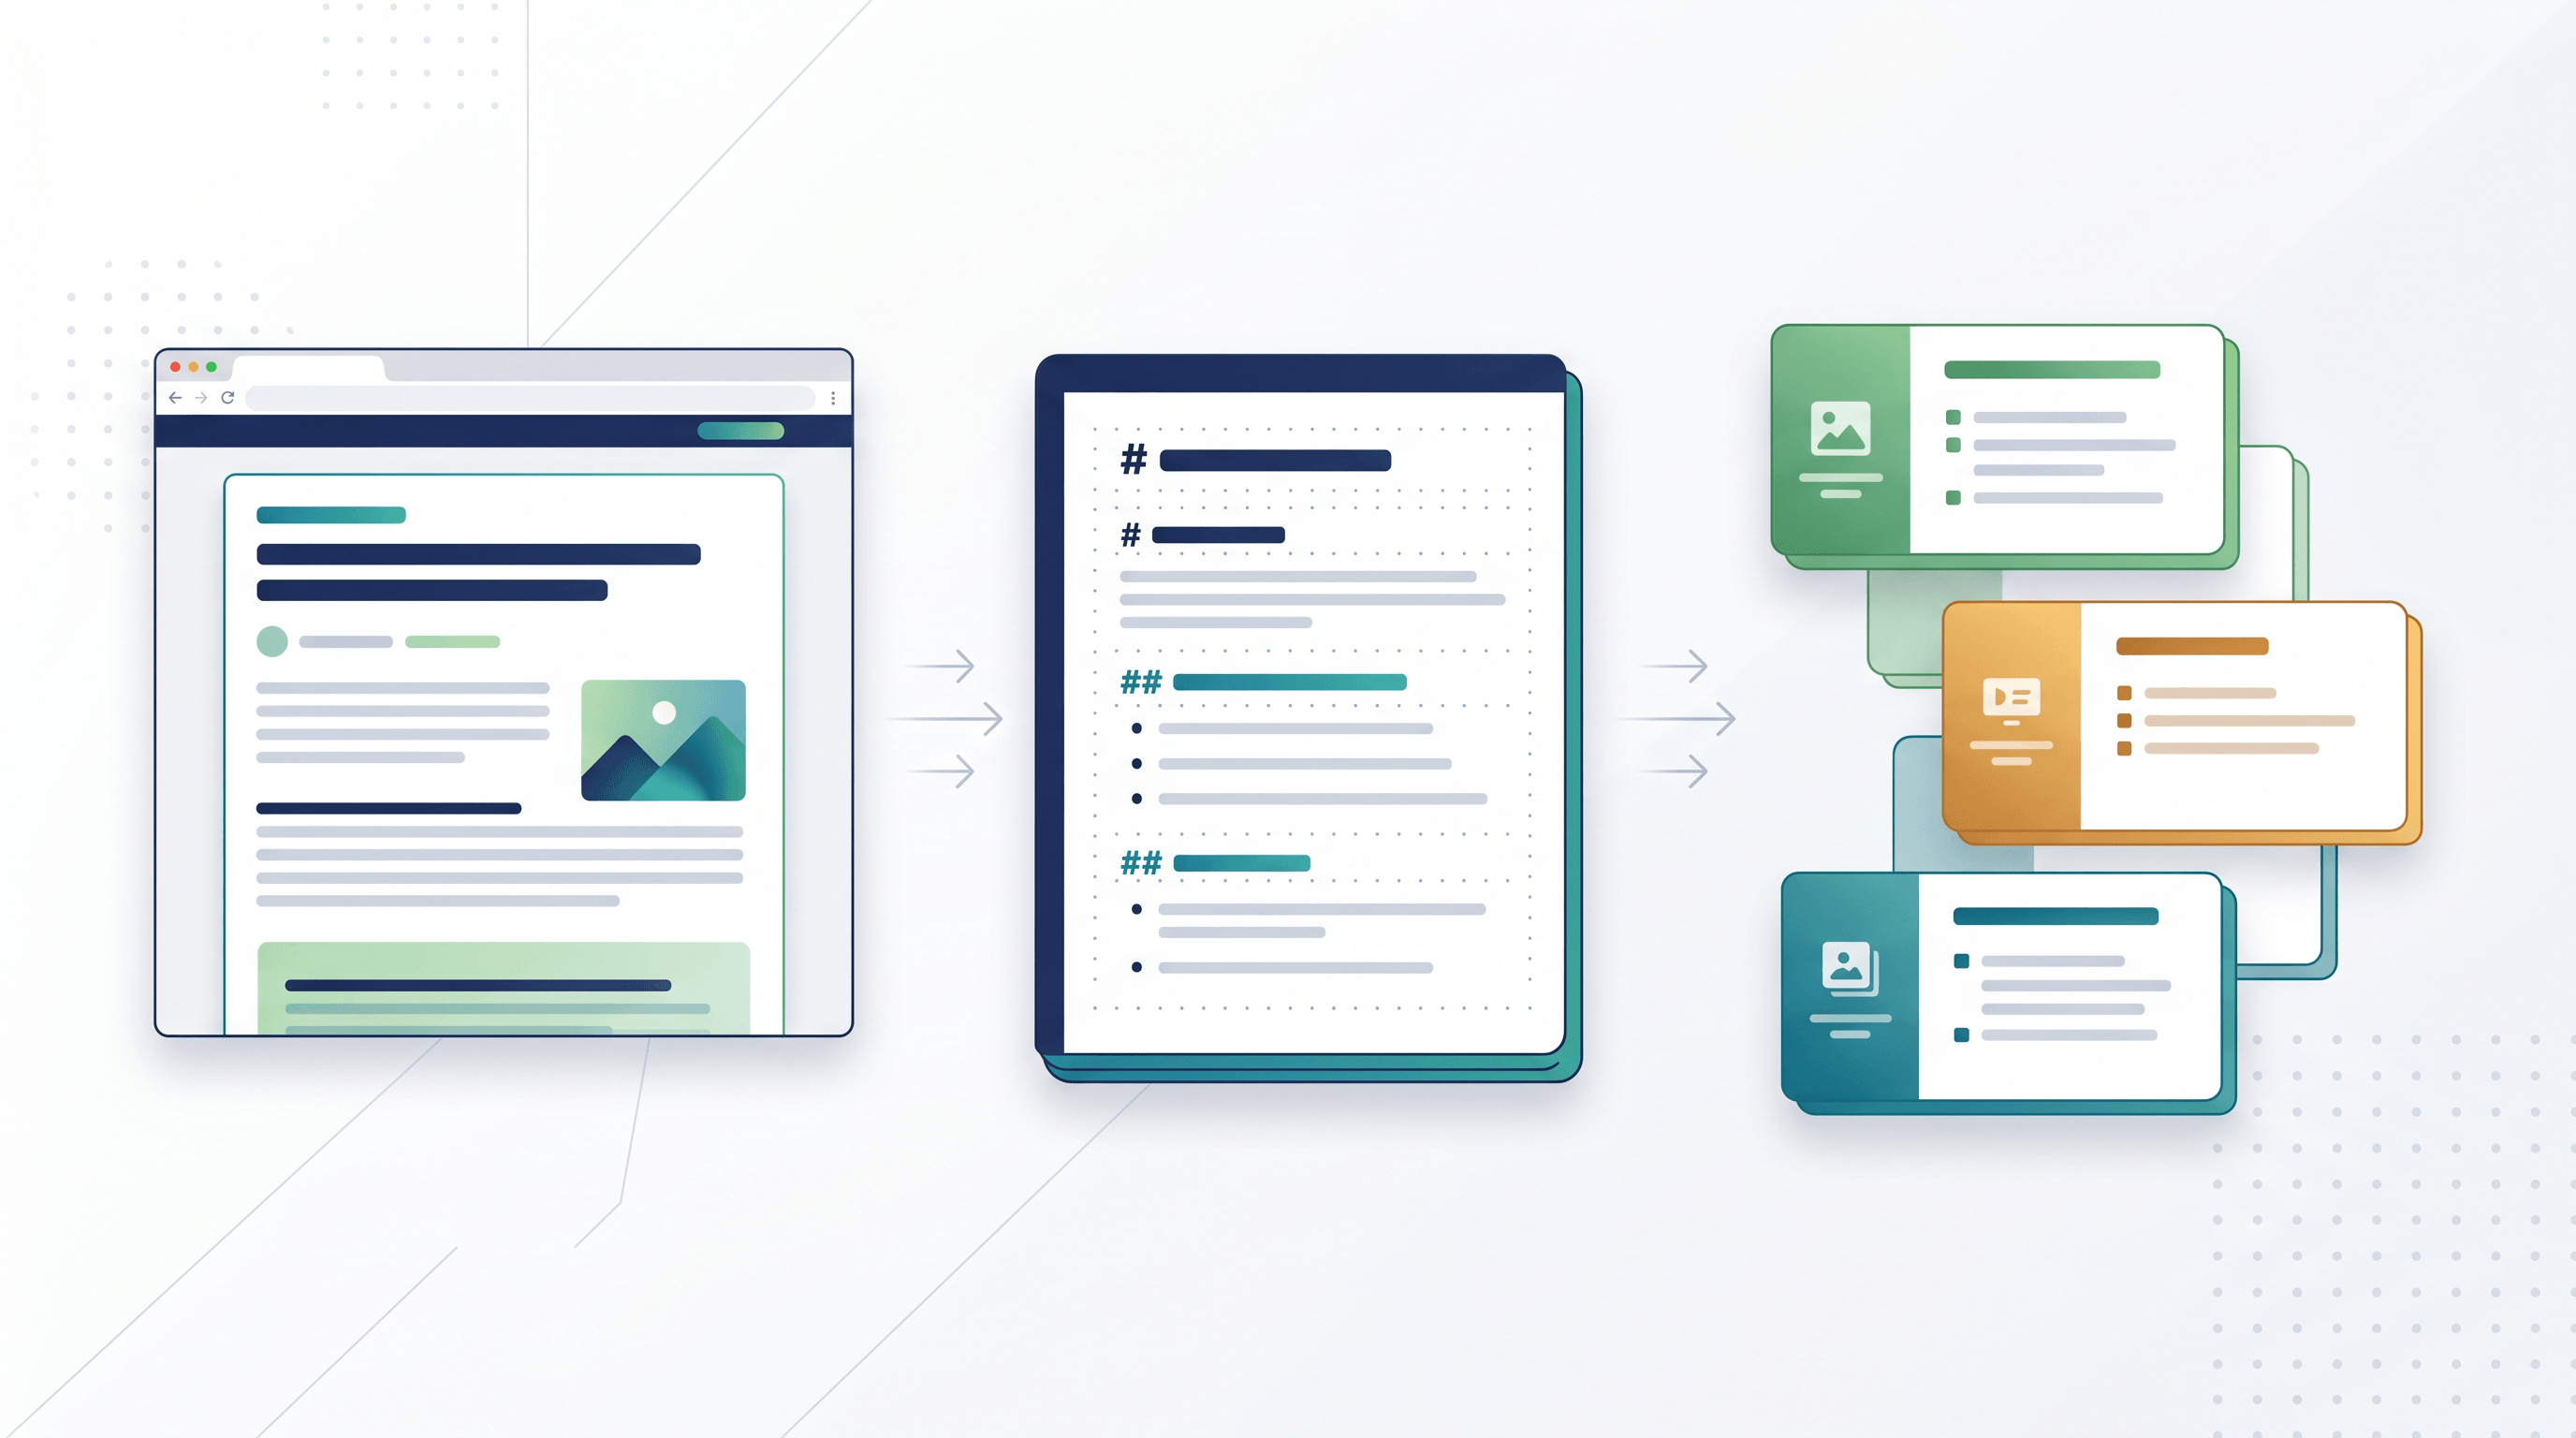
网页转 PPT 大纲:把文章变成 AI 幻灯片
学习 6 步 webpage to PPT outline 工作流:先把网页转 Markdown/Text,再整理成适合 AI PPT 的大纲。
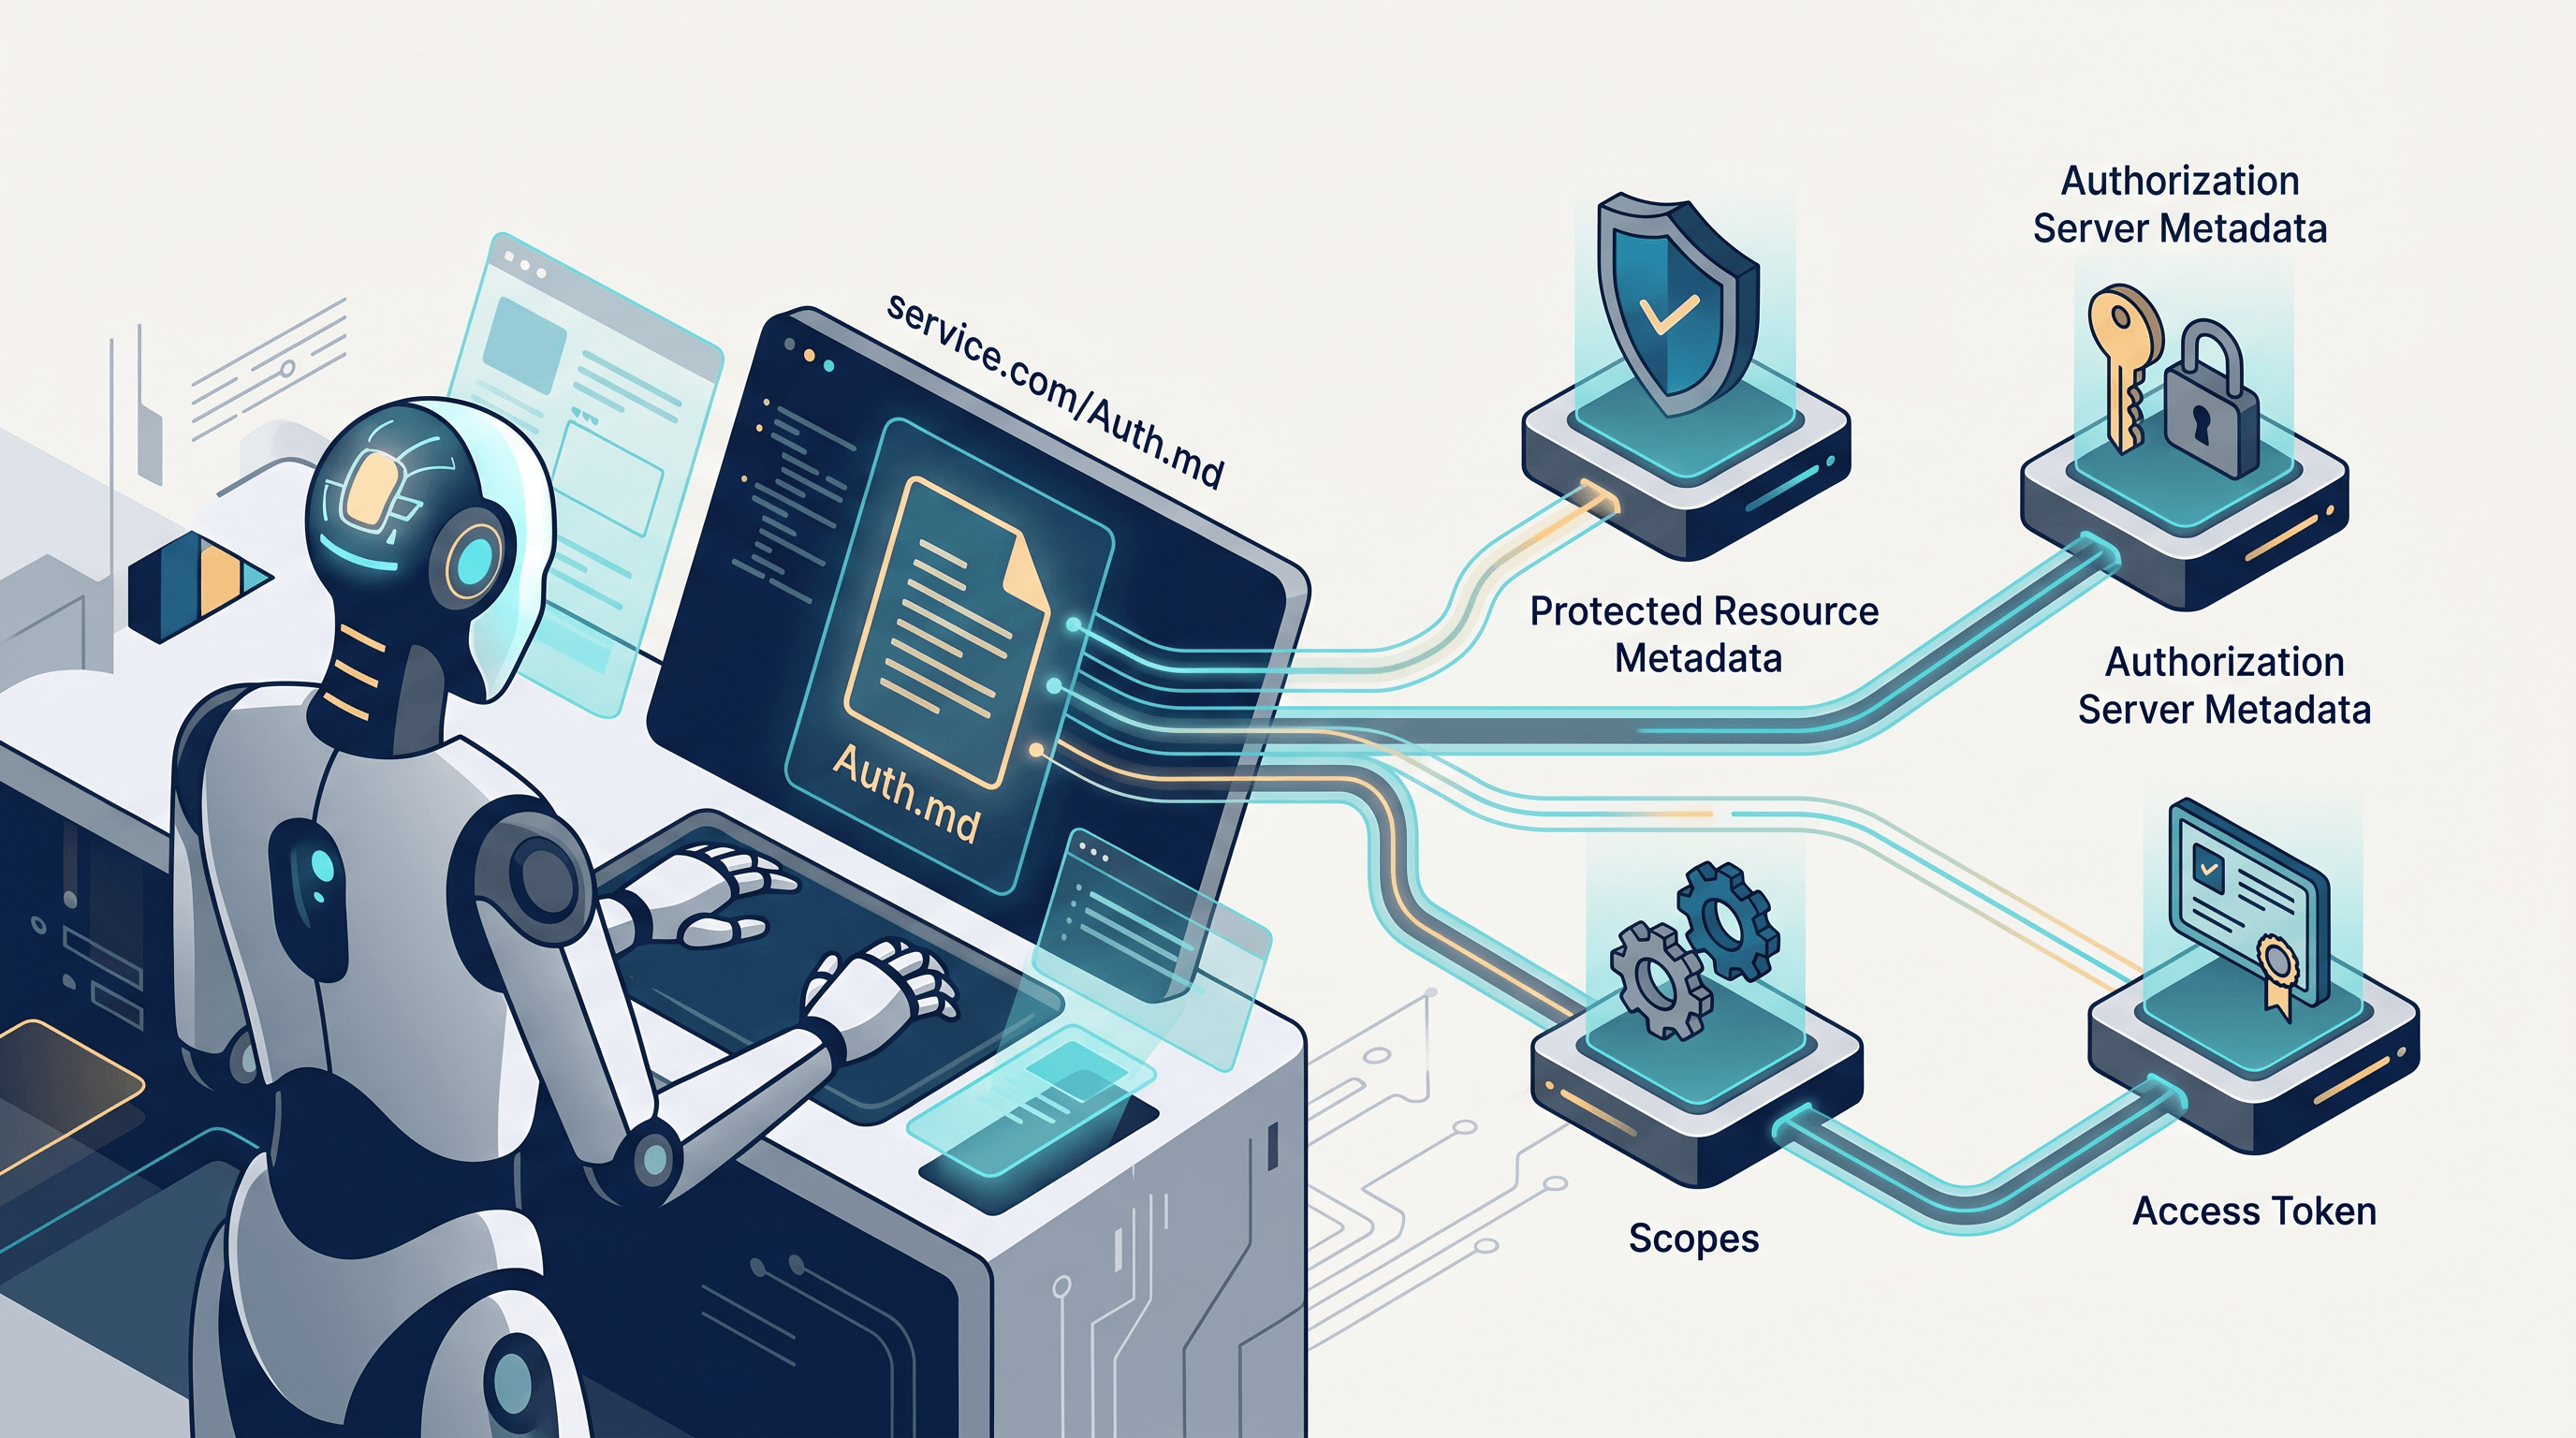
什么是 Auth.md?AI Agent 的 OAuth 发现协议
Auth.md 让 AI Agent 从根目录 Markdown 发现 OAuth 注册信息。了解协议流程,并用 URL to Any 检查 auth.md。
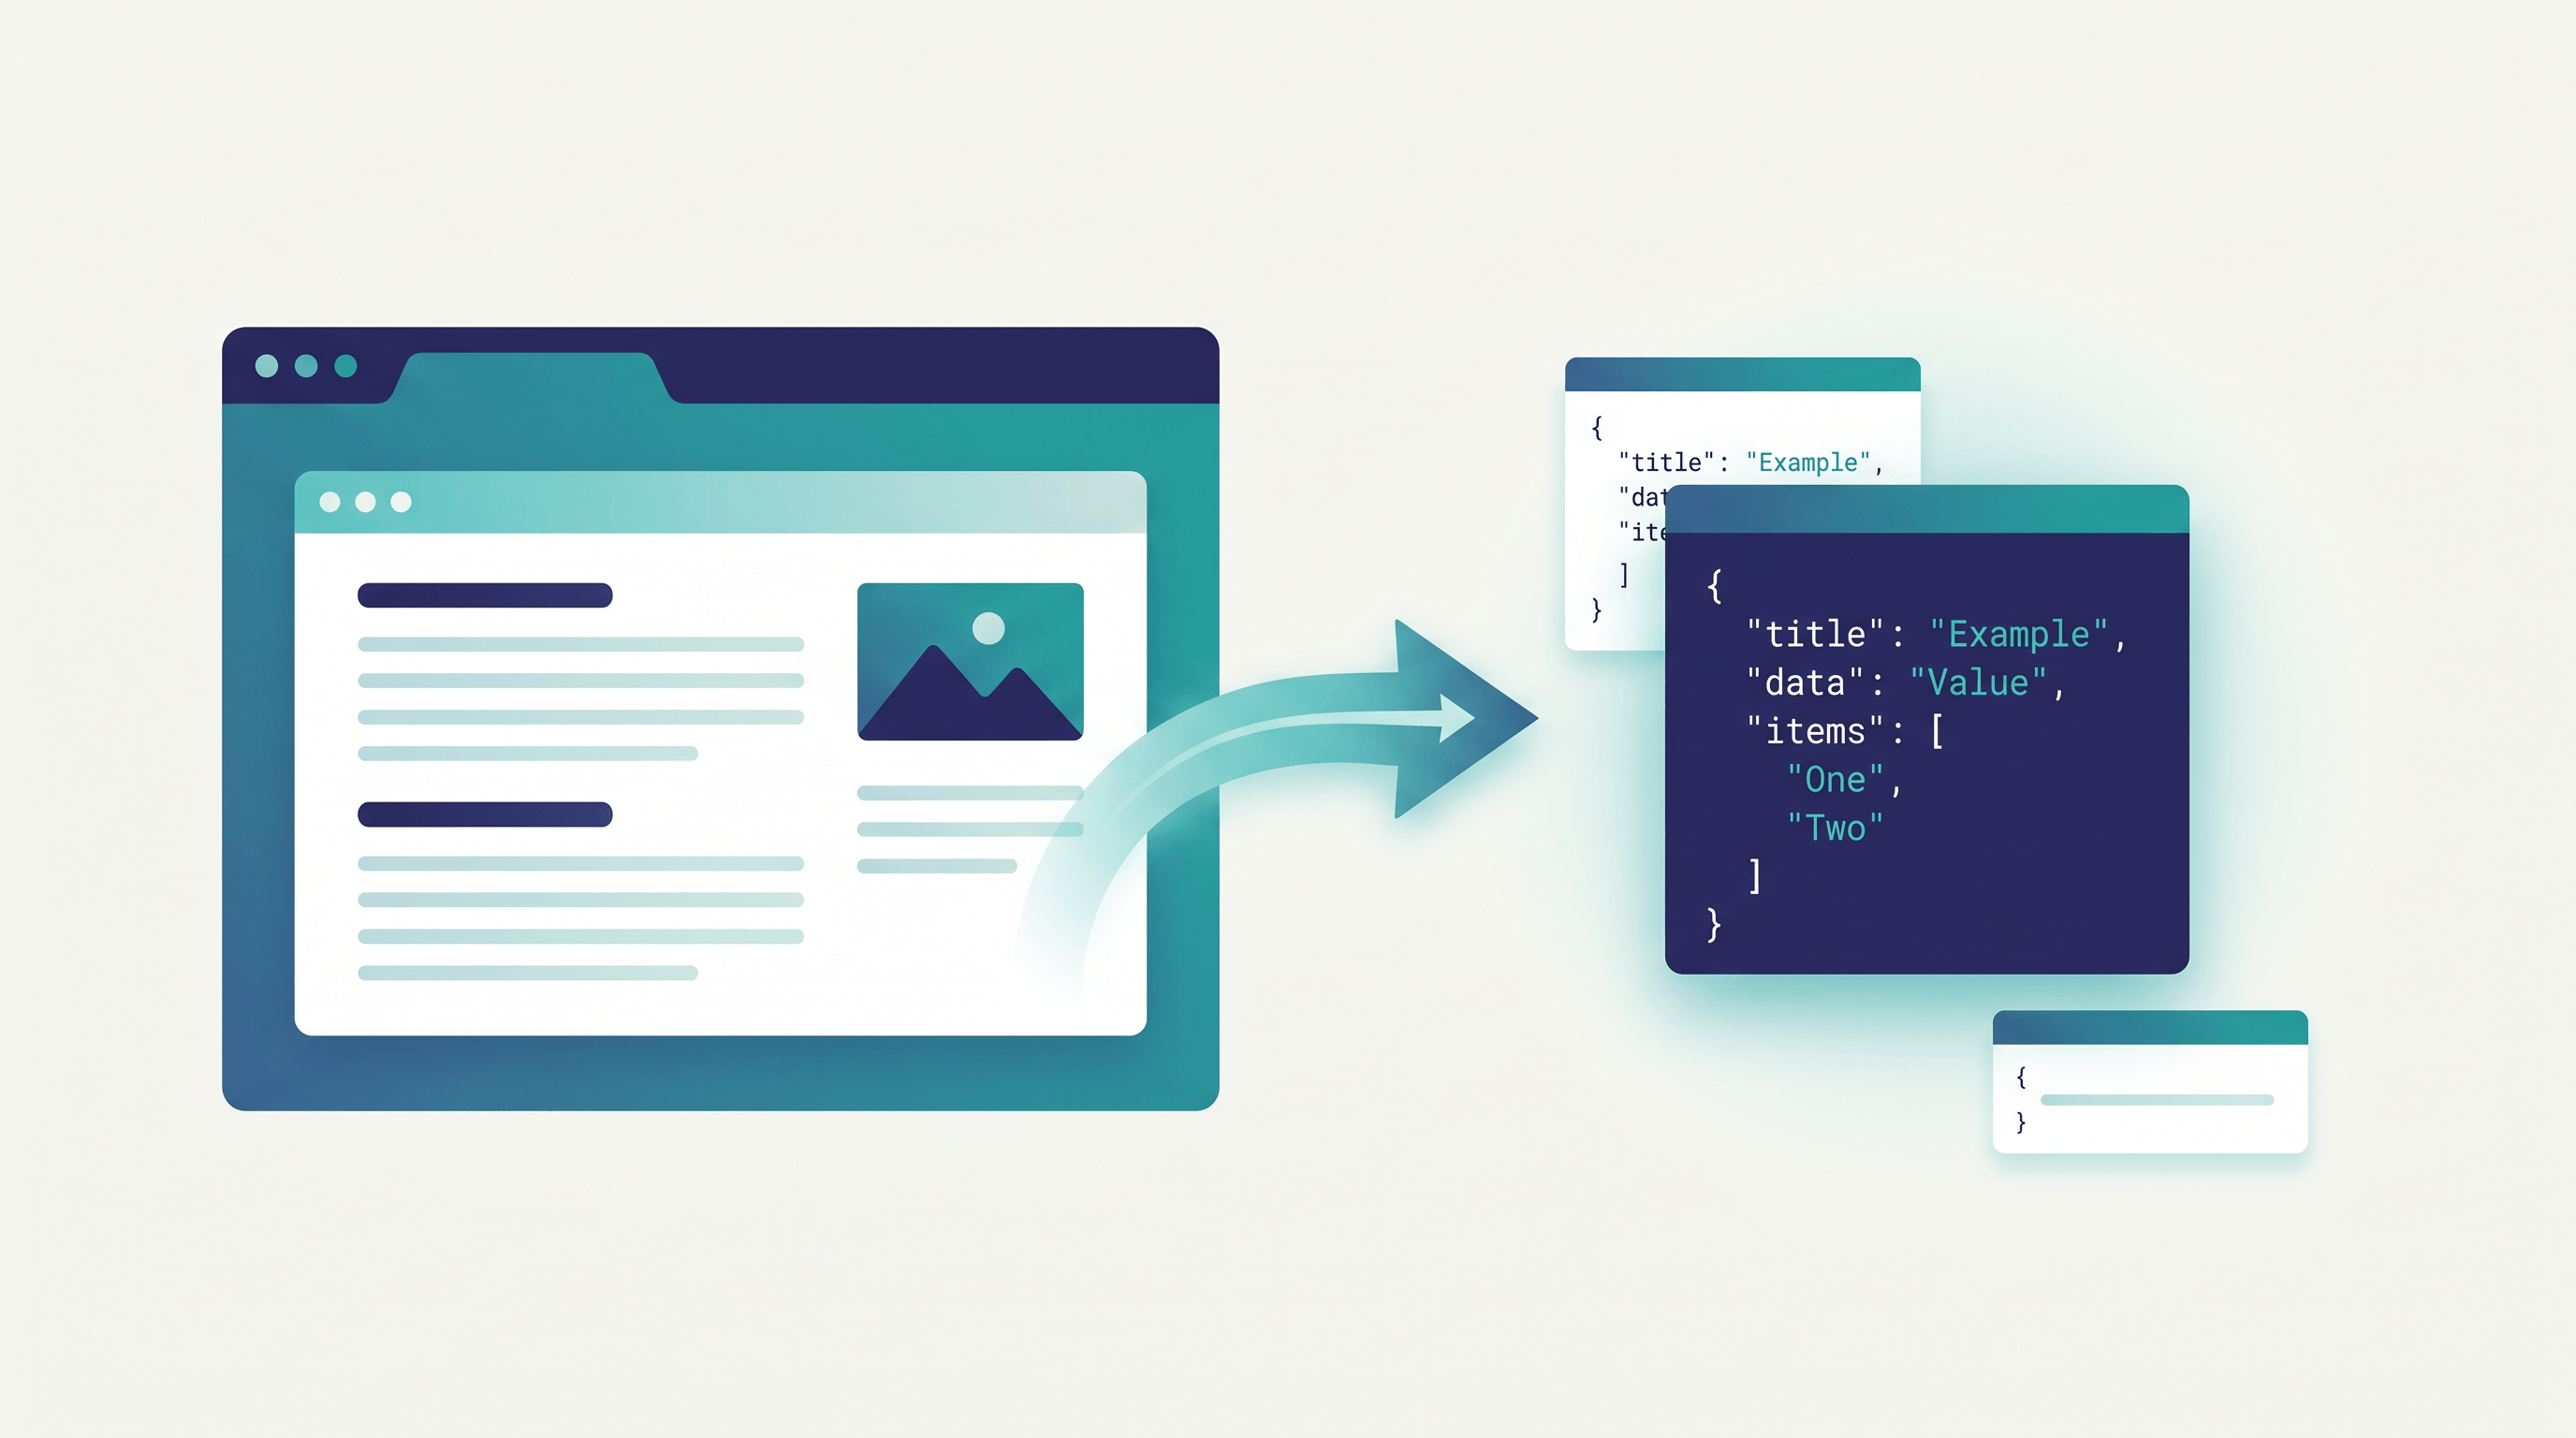
如何把网页数据提取成 JSON(无需写爬虫)
无需搭建爬虫,把网页数据快速提取成 JSON。一个轻量的 URL 转 JSON 工作流,几秒钟从任意网页拿到结构化数据。
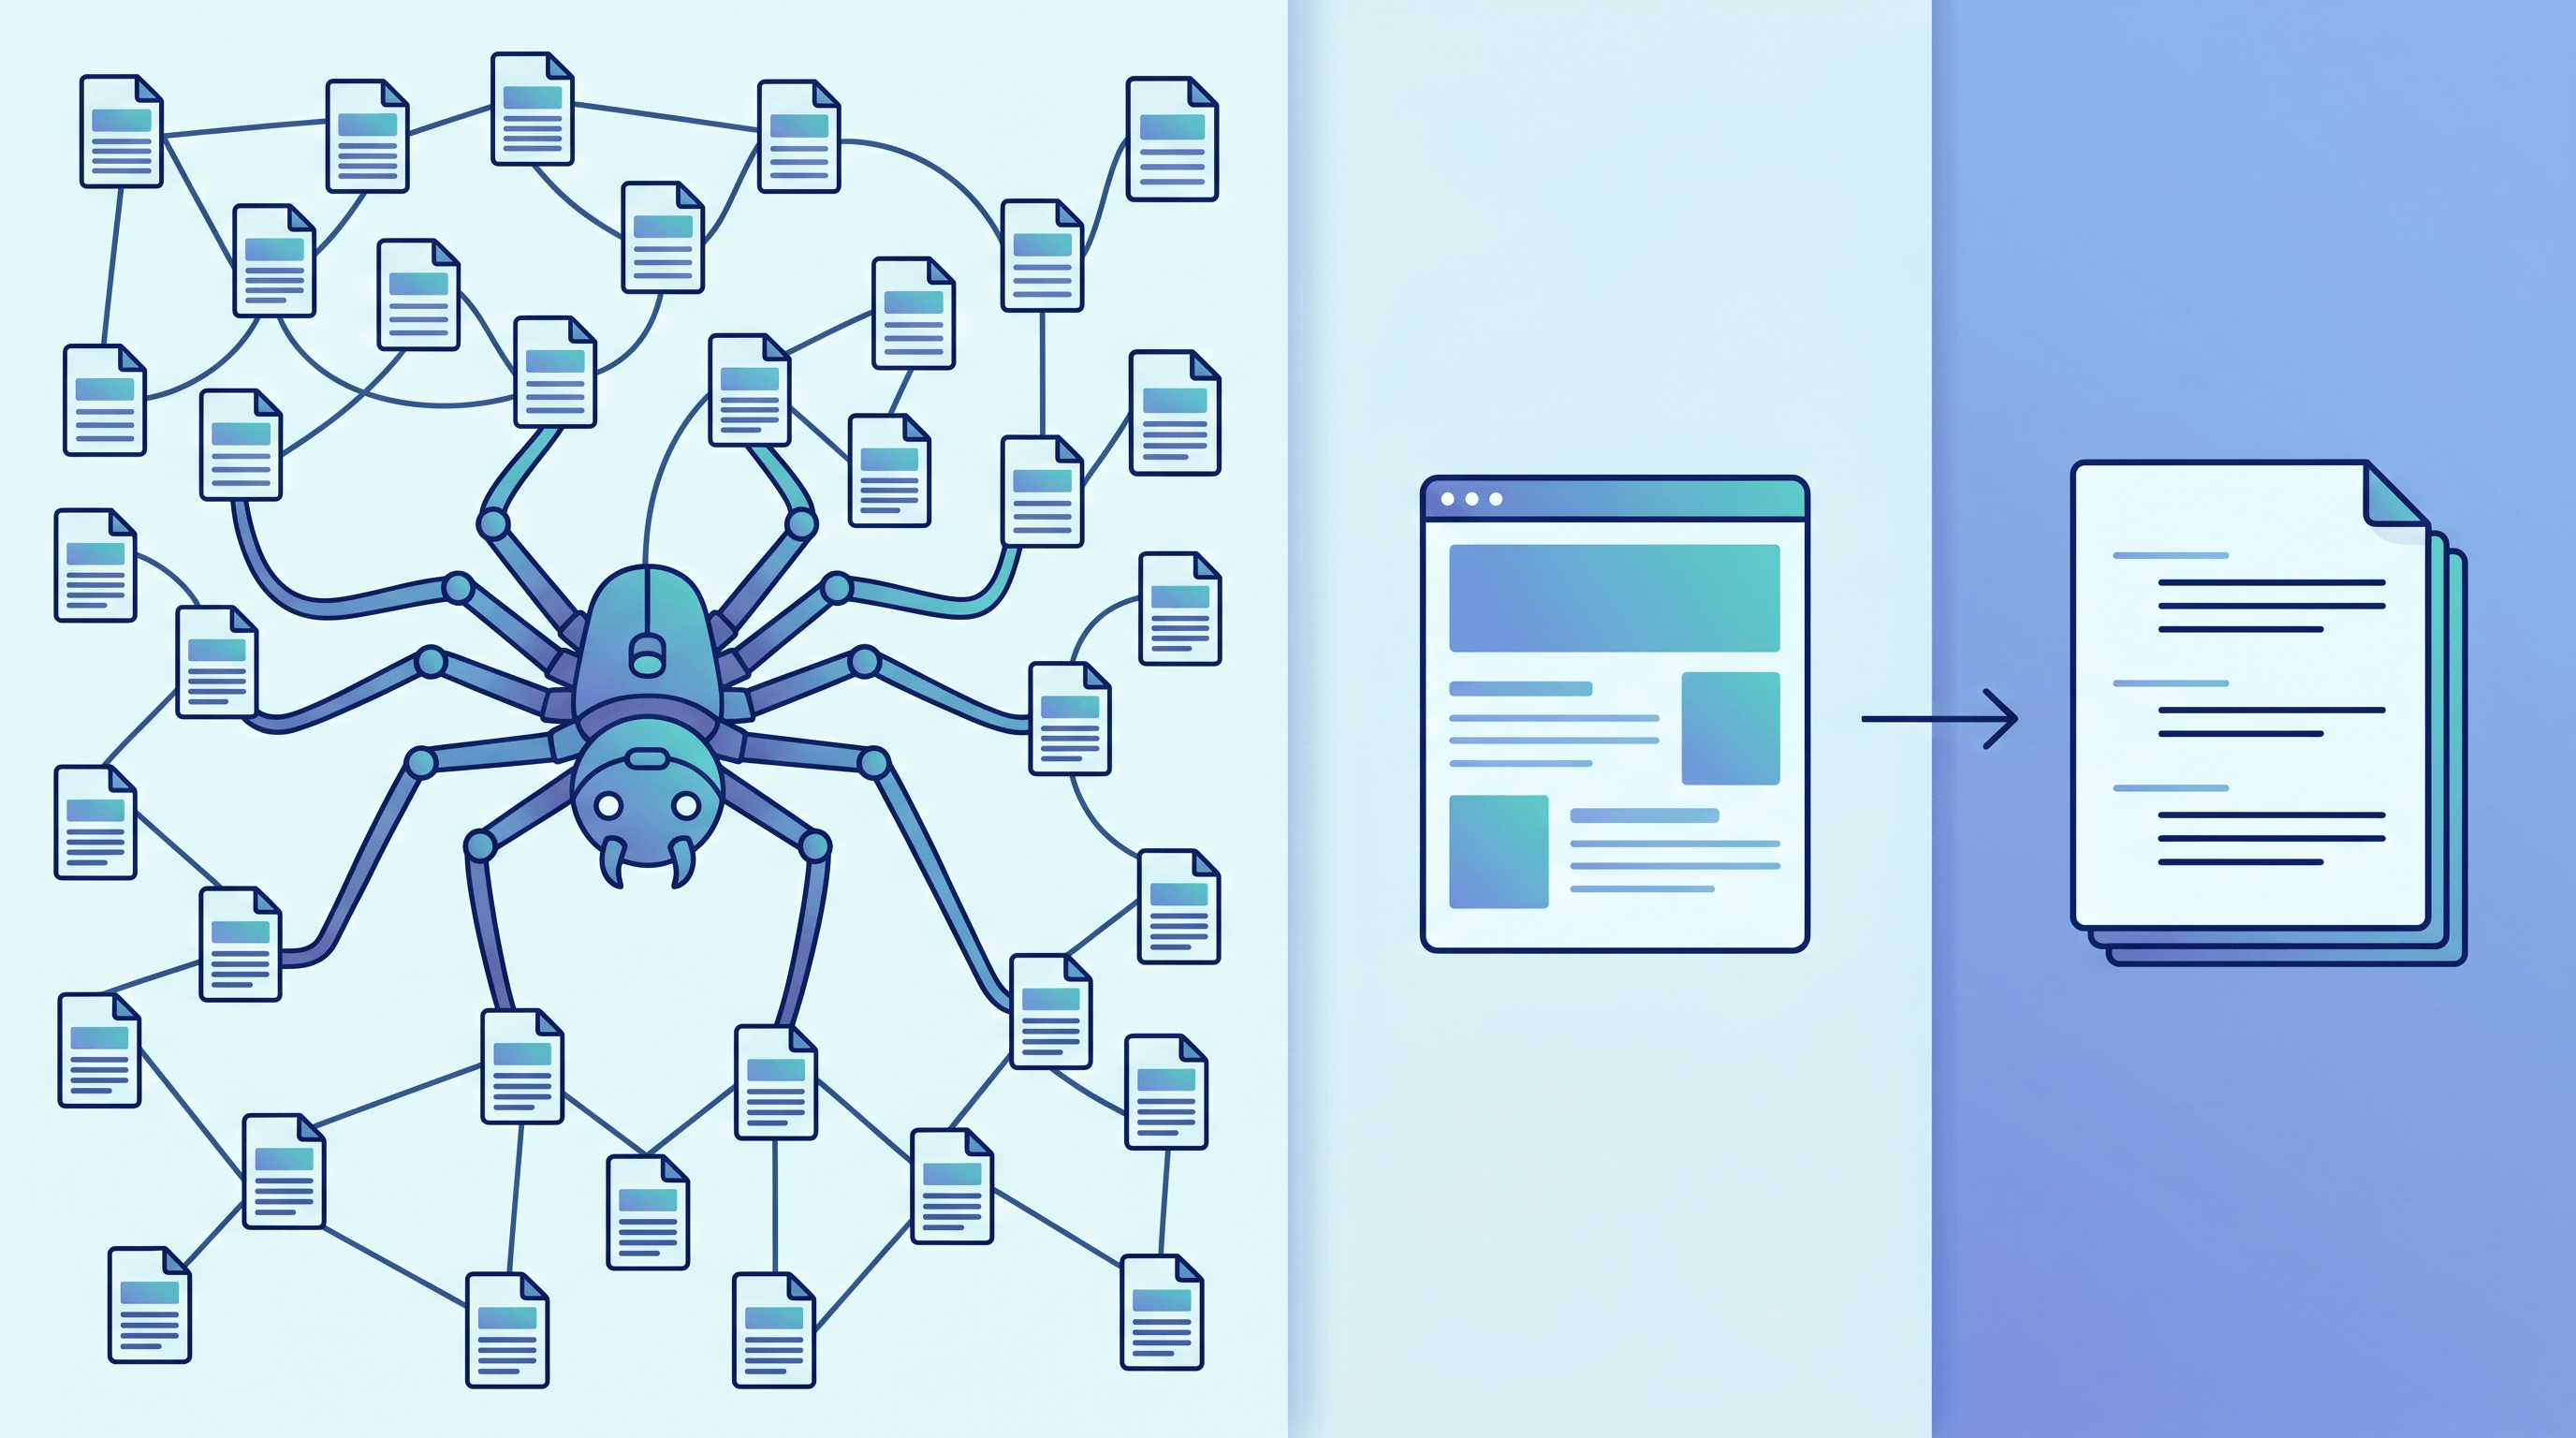
Firecrawl 替代方案:单页 URL 转 Markdown 何时就够
Firecrawl 替代方案指南:什么时候不需要完整爬取 agent(如 Prometheus),只需把单页 URL 转成 Markdown 或 JSON 喂给 LLM。2026-06-14 更新。
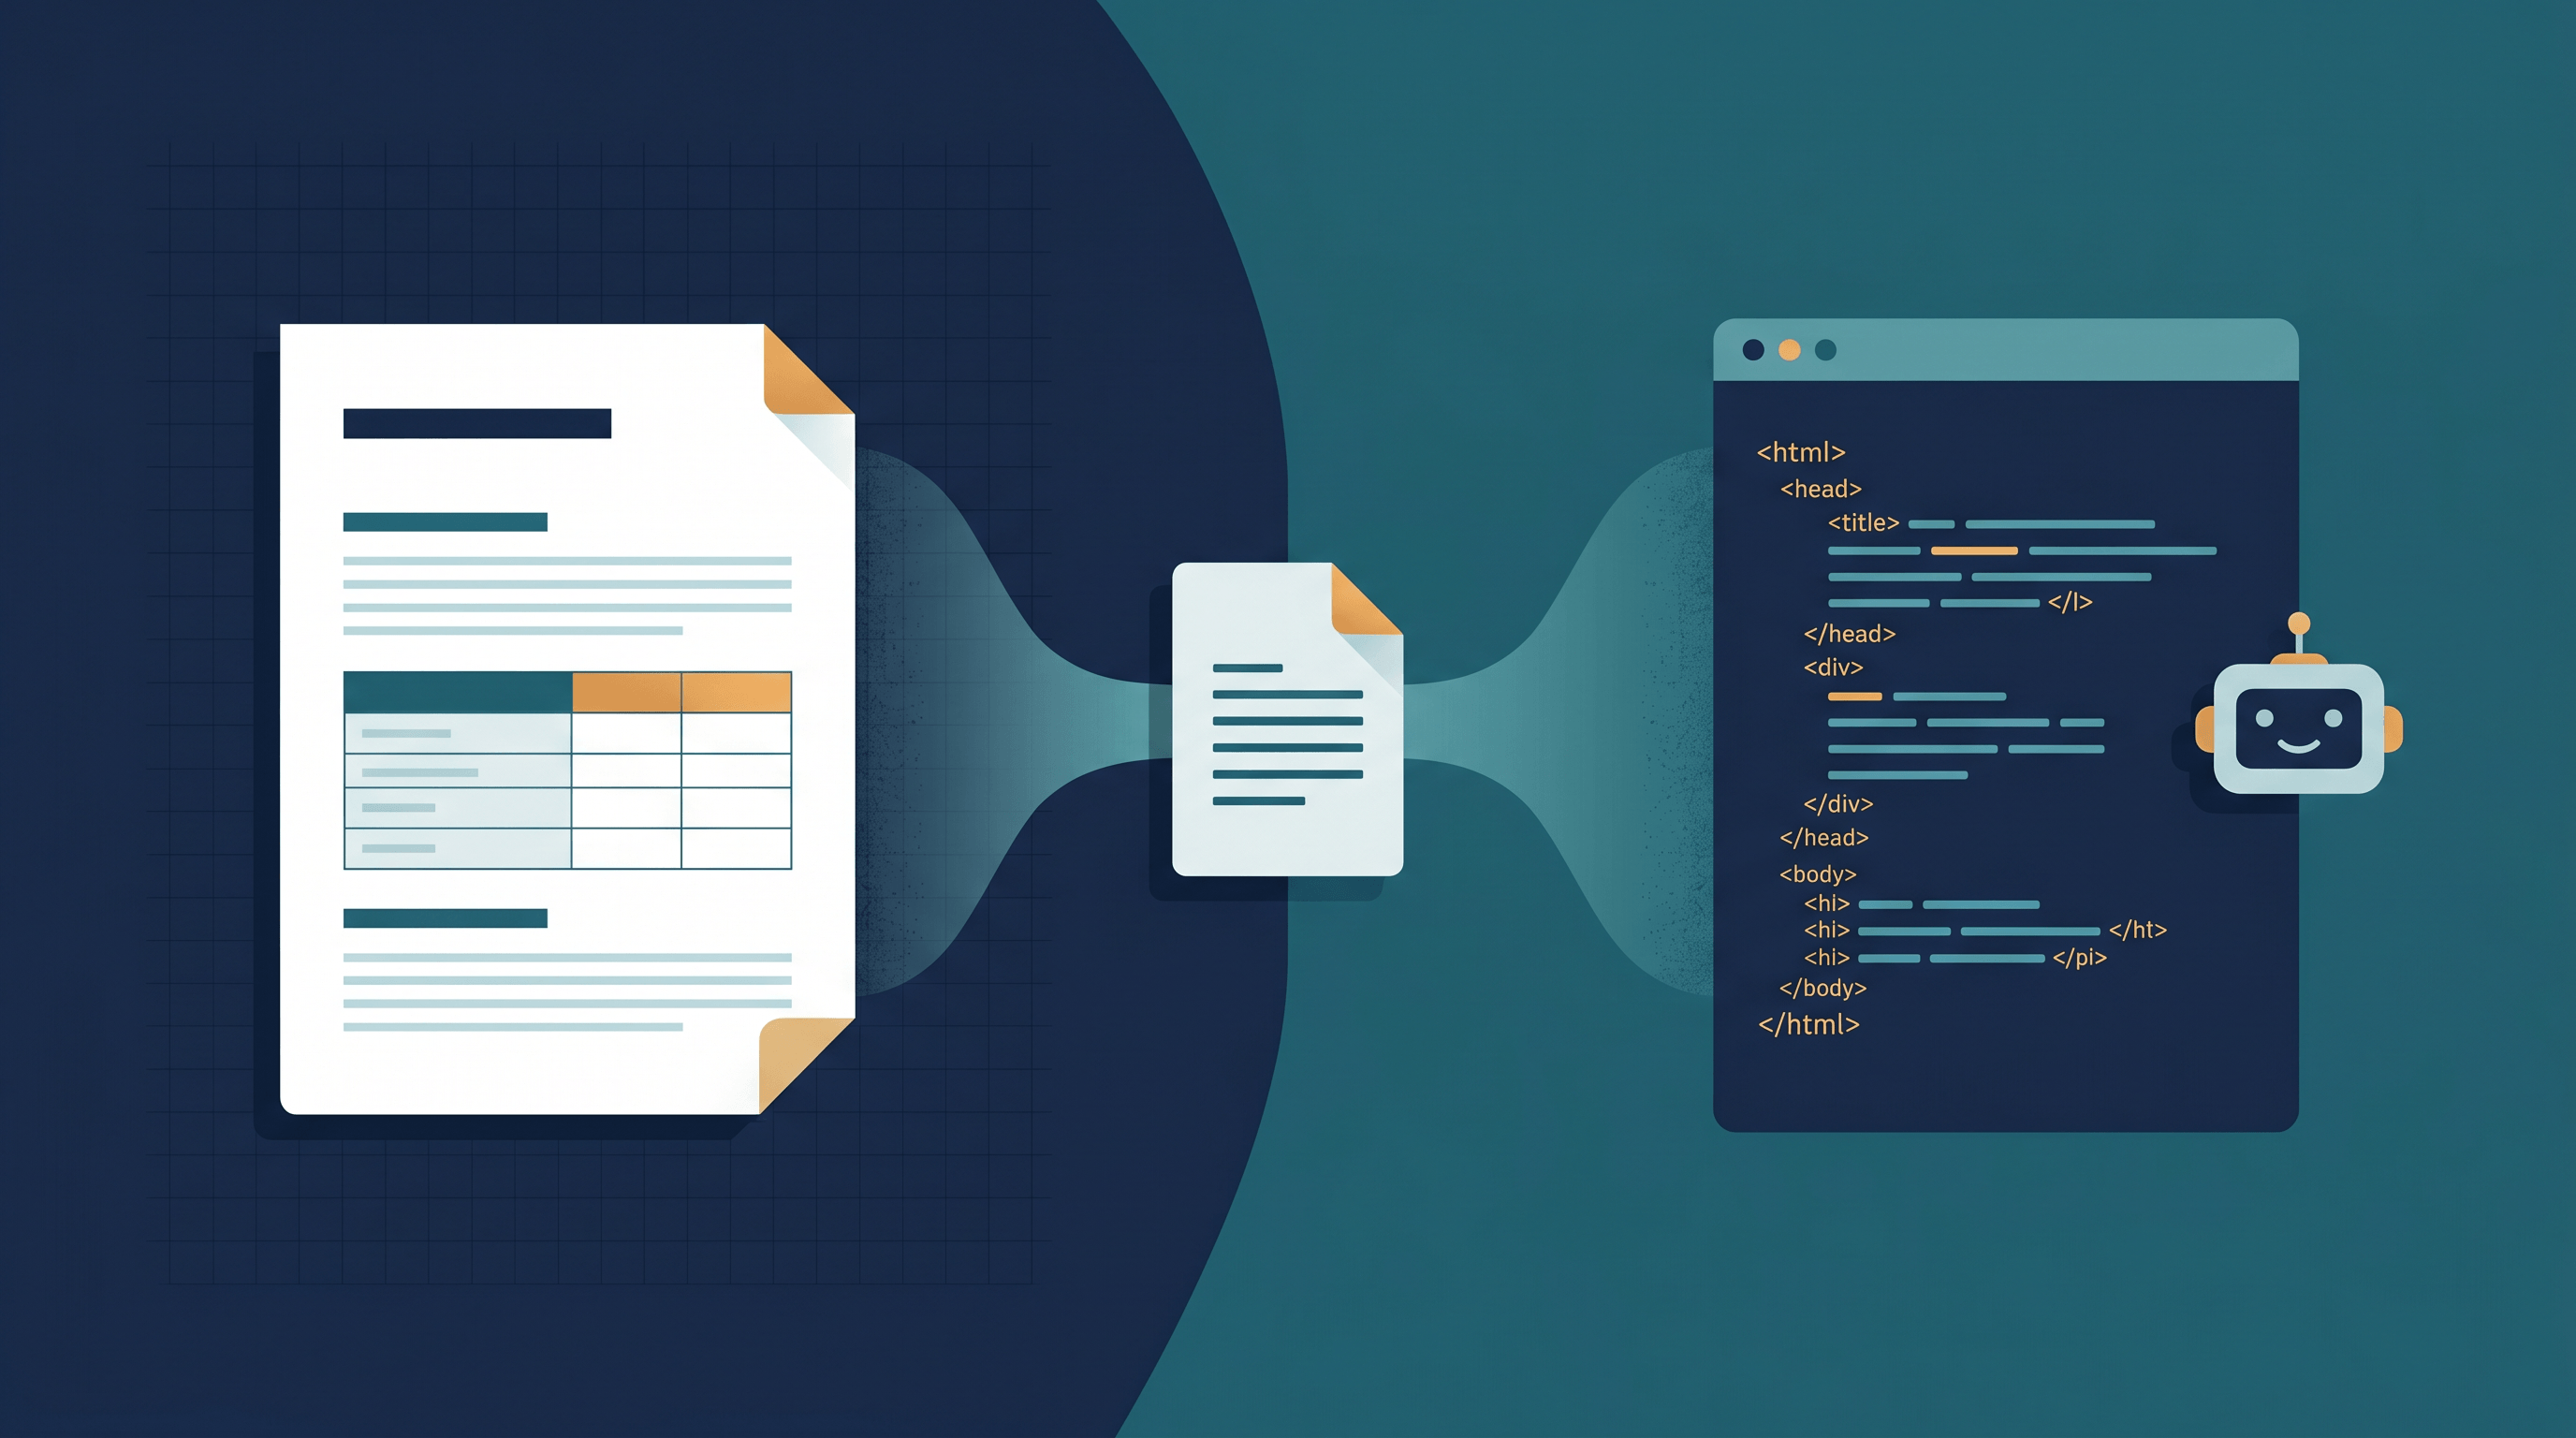
什么是 Adaptive PDF?与响应式 PDF 的区别
Adaptive PDF 对人显示正常排版,却给机器返回干净 Markdown。看它和 responsive PDF、网页 PDF 到底有什么区别。
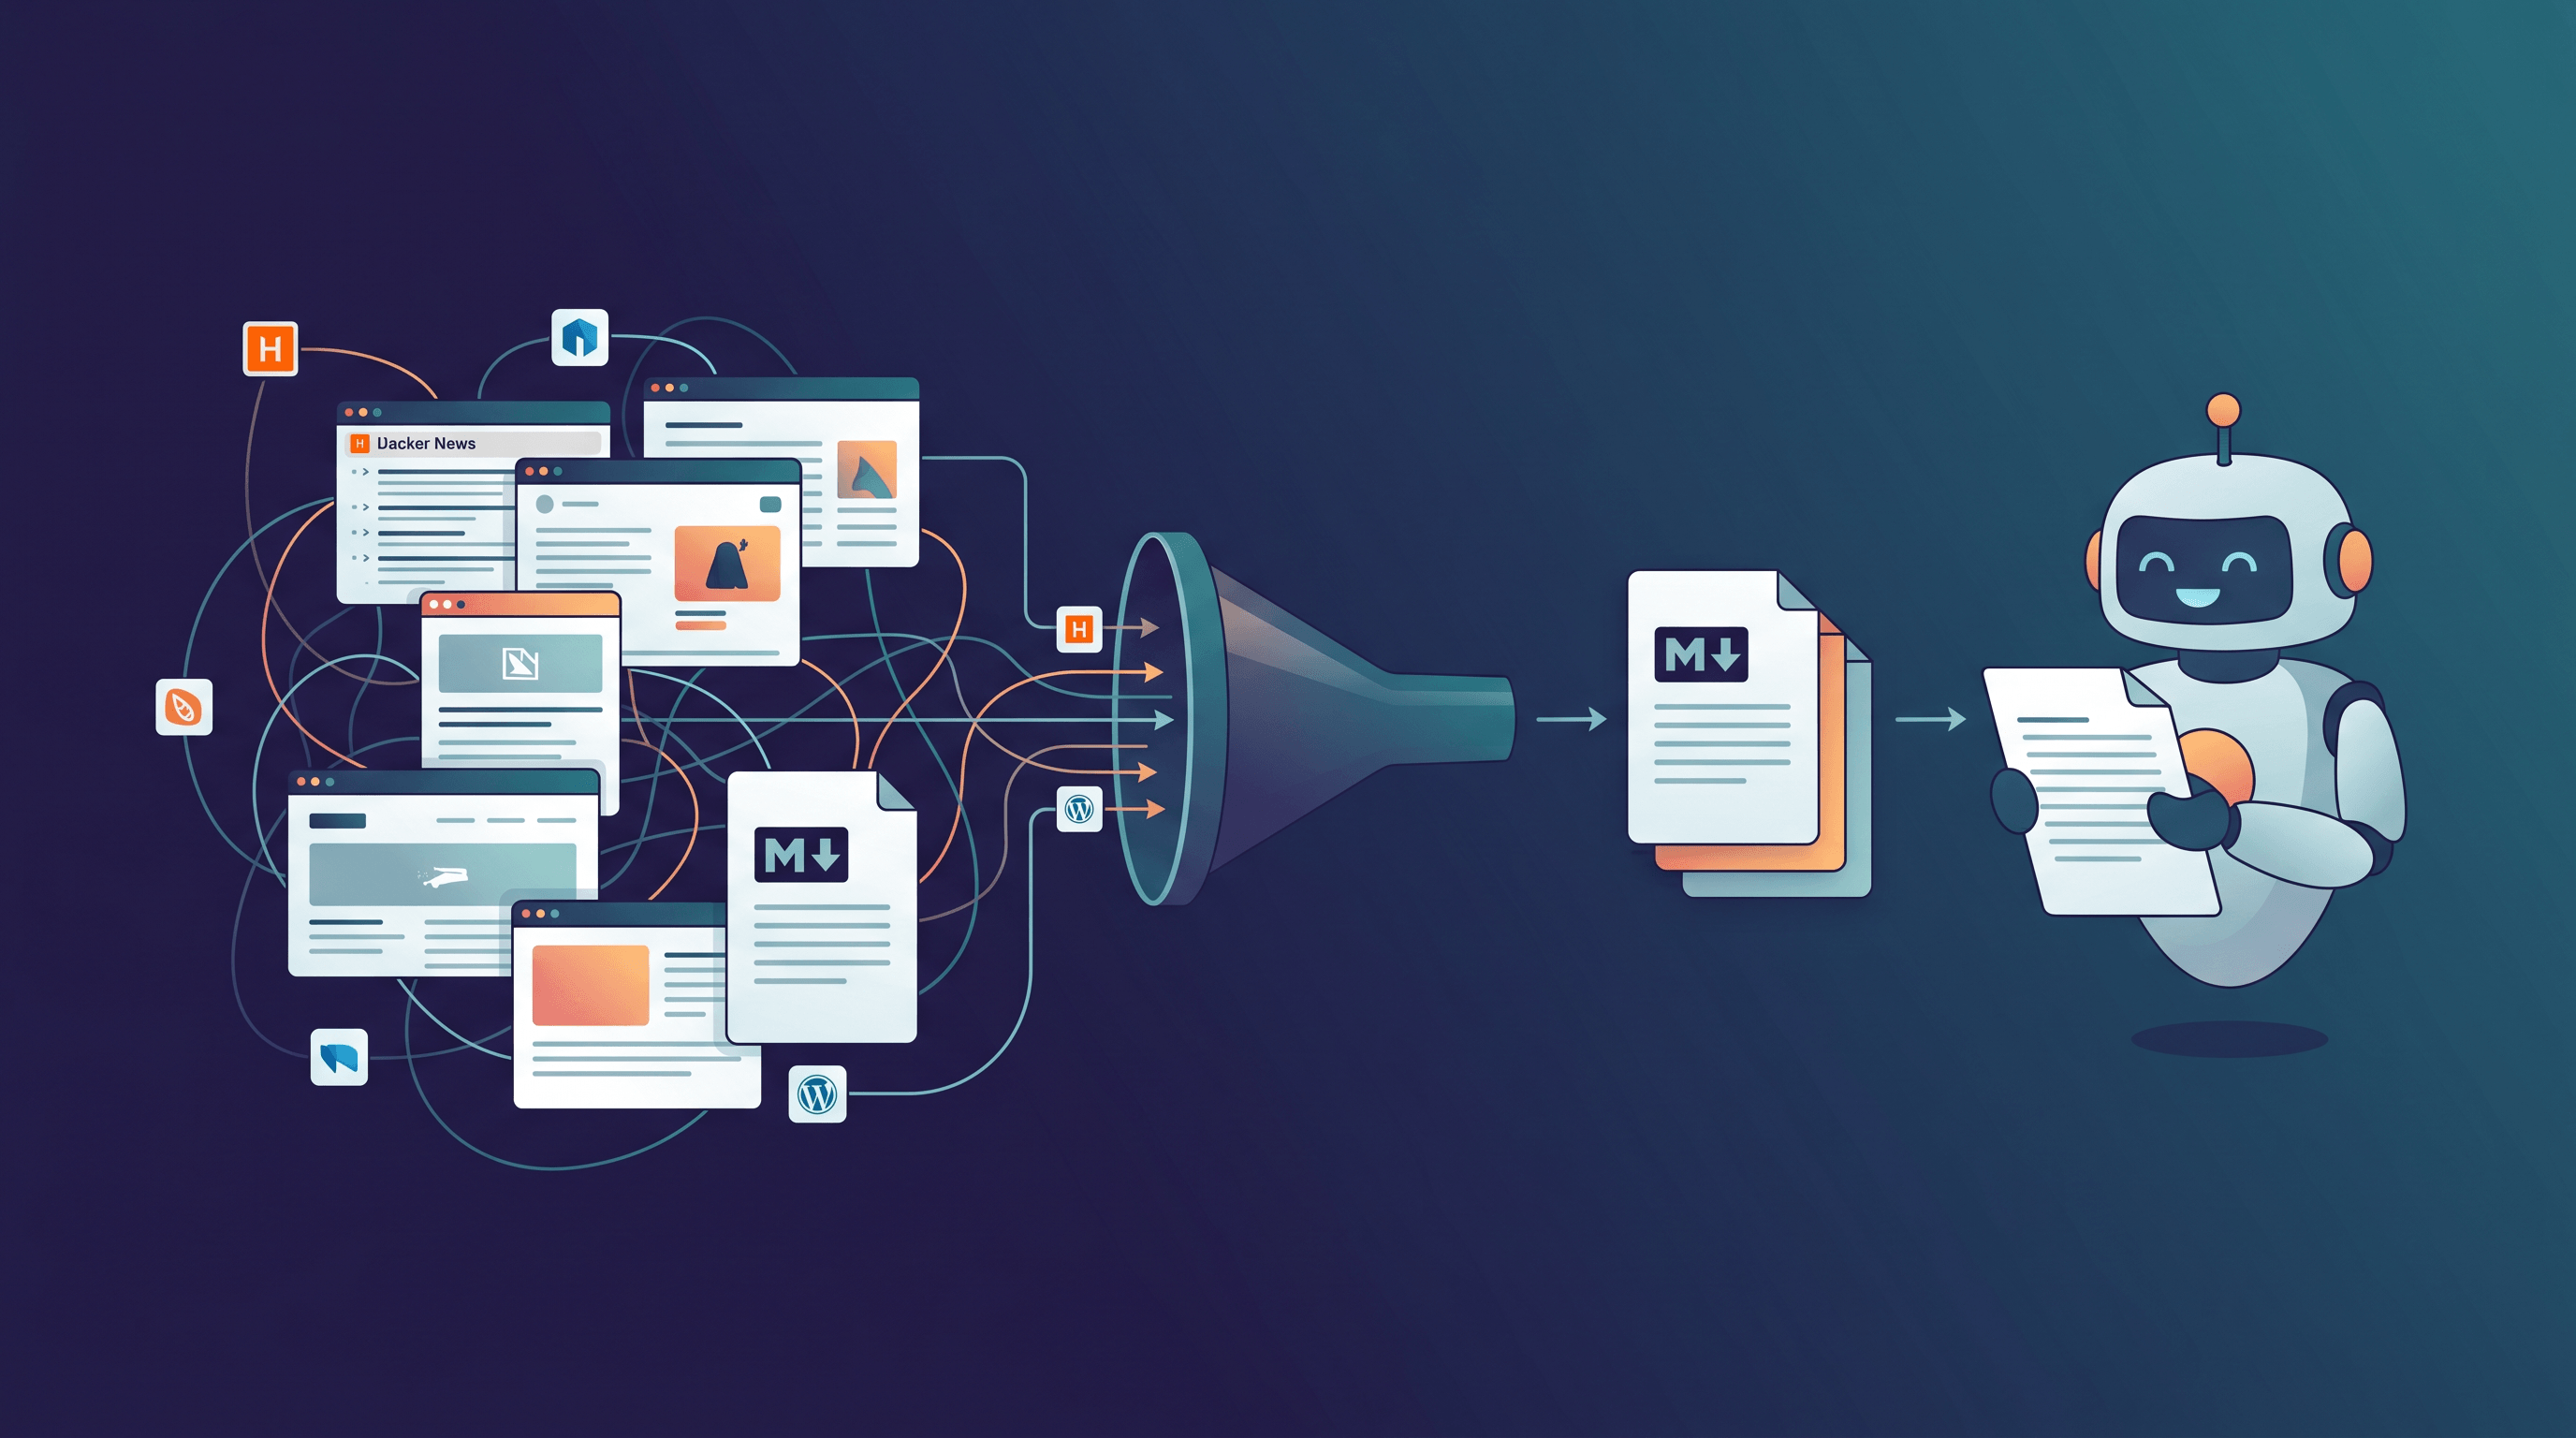
如何用 URL 构建近 30 天研究简报
把近 30 天的 URL 转成干净的 Markdown 研究简报:去噪声、可引用、每月可复用,喂给 AI 总结更准。一套五步可复用流程。