
Cloudflare「禁止 AI 训练」新规:网页转 Markdown 工作流要注意什么
Cloudflare 的 Disallow AI Training 设置把搜索收录与 AI 训练解耦。这次爬虫新政对网页转 Markdown 提取意味着什么,抓取工作流又该怎么调整。
Cloudflare 的网络挡在互联网相当大比例的站点前面。2026 年 9 月 15 日,它改写了「谁能抓取一个页面」的规则:新的**Disallow AI Training(禁止 AI 训练)**设置让网站可以保持搜索收录、同时拒绝 AI 训练;而 **Block(封锁)**控制现在也能覆盖驱动 Google、Bing、Apple 搜索的混合用途爬虫。
如果你在跑一条网页转 Markdown 的工作流——转换工具、研究流水线、或者把页面拉成干净文本的 Agent——这次政策改变的是你的可用性假设:更多网站会对不同的抓取者给出不同的答案,robots.txt 正在变成机器发布的偏好声明,上个月还能正常抓的页面可能开始返回 403 或人机验证页。
本文拆解 Cloudflare 官方公告里真正变了什么、解释为什么提取类抓取首当其冲,并给出让 convert-url-to-markdown 流水线持续可用的具体调整:诚实的 User-Agent 标识、robots.txt 感知、缓存策略,以及体面的失败降级路径。
核心要点
- Cloudflare 现在把爬虫行为分为三类——Search(搜索)、Training(训练)、Agent(代理)——并在域名层级、面向所有套餐分别控制。
- Disallow AI Training 拆开了以前的两难:网站保持搜索收录,同时封锁一切非搜索的训练爬虫;获得「Accountable(可问责)」认定的混合用途爬虫(Applebot、Bingbot、Googlebot)仍可为搜索抓取。
- Block 现在同样作用于混合用途爬虫——站点一旦选择,Applebot、Bingbot、Googlebot 整体止步,搜索也不例外。
- 面向新域名的推荐预设里,投放广告的站点默认把 Agent 设为 Block on pages with ads(广告页封锁)——收紧的不只是训练爬虫,还有自动化抓取。
- robots.txt 不再只是「礼貌建议」:Cloudflare 的 Bot Preference Sync 会把站点偏好直接写进 robots.txt,而且无论爬虫读不读这个文件,网络层都会执行。
Cloudflare 到底改了什么
Cloudflare 的核心思路是按行为分类。同一个 bot 可能表现出多种行为,公告定义了三类:Search(建搜索索引)、Training(训练或微调模型)、Agent(受用户委托访问页面的代理,例如聊天取数 bot 和 browser-use agent)。混合用途爬虫就是同一个爬虫既做 Search 又做 Training——这正是过去站长的两难来源:放行它就得接受训练,拒绝它就从搜索里消失。
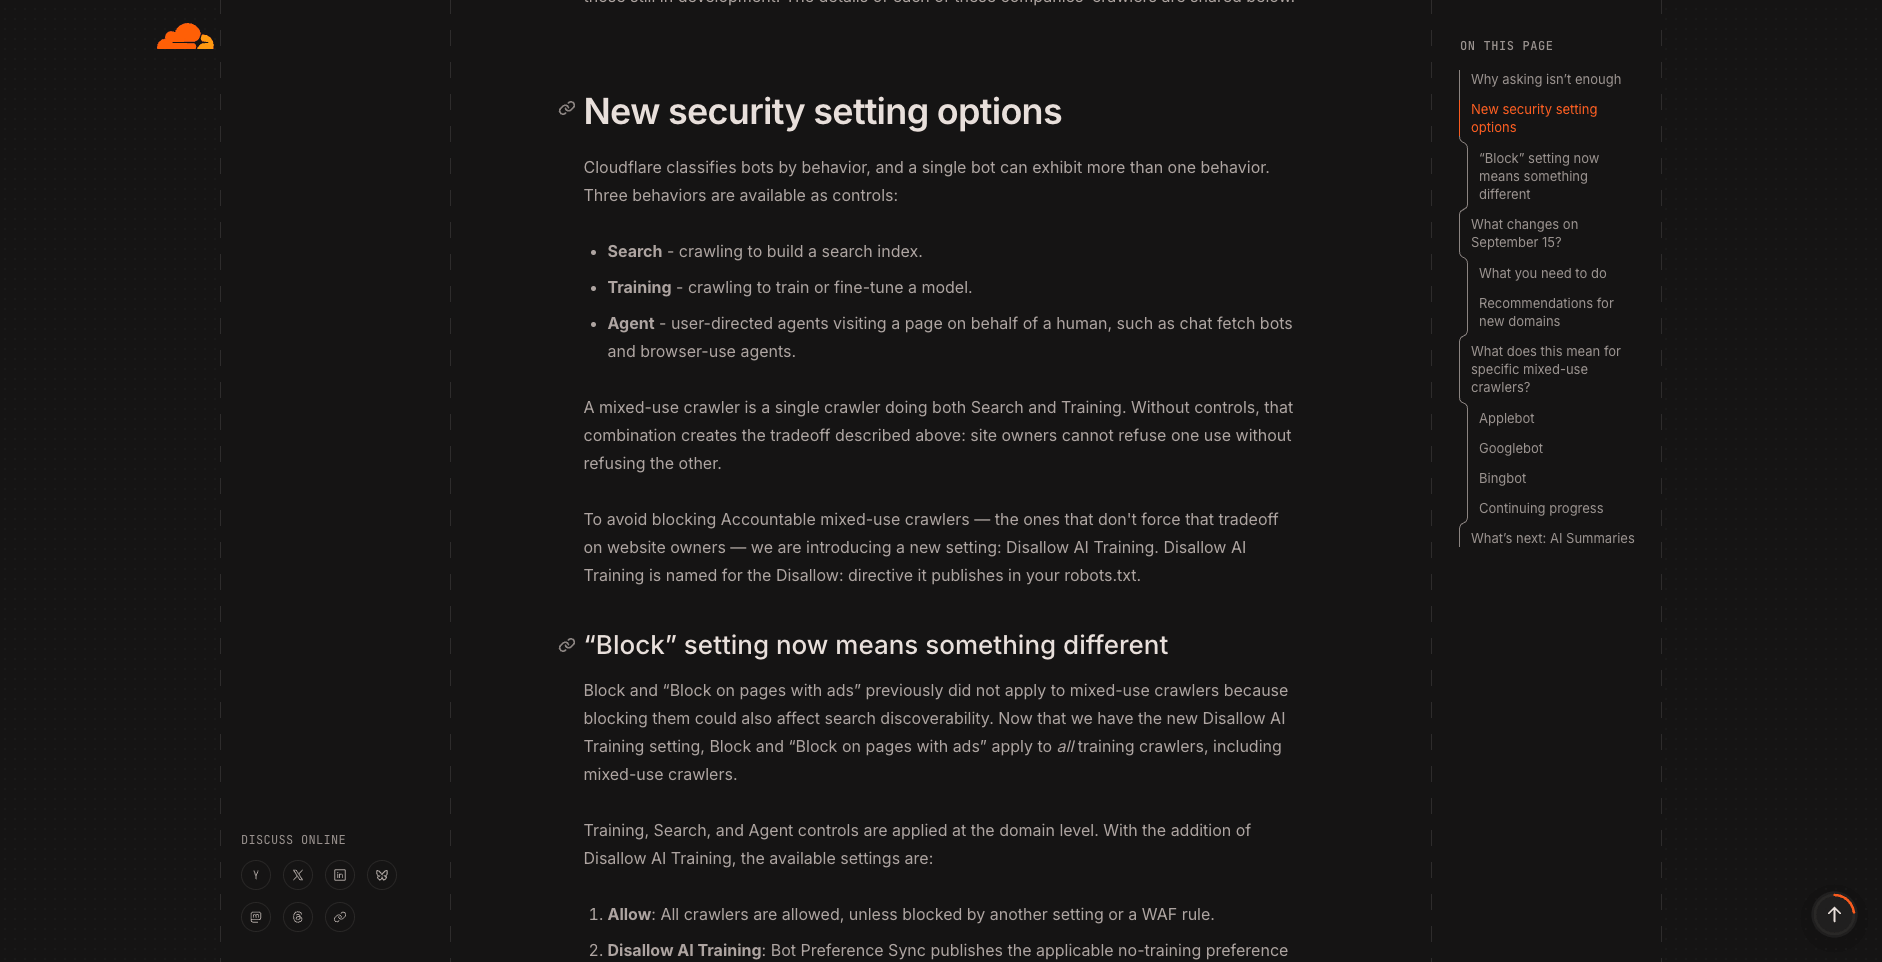
Cloudflare 2026 年 9 月 15 日公告中的四种爬虫设置(来源:Cloudflare Blog,访问于 2026-09-18)
新的 Disallow AI Training 设置消除了这个两难。在该设置下,Accountable 混合用途爬虫仍可为搜索抓取,其余所有训练爬虫一律封锁——包括 Amazon、Anthropic、Meta、OpenAI 运营的纯训练爬虫。Cloudflare 表示,Apple、Google、Microsoft 要么今天已遵守该偏好,要么已承诺在明确时间范围内遵守——这也是它们获得 Accountable 认定的原因。
与设置一同到来的是两项弃用:旧的 **「Block AI Bots」**开关被细粒度的 Search/Training/Agent 控制取代;Managed Robots.txt 被 Bot Preference Sync 取代——后者负责把站点的禁止训练偏好直接写入 robots.txt。这些控制都在域名(zone)层级生效,且所有套餐可用。
存量域名无需任何操作——现有设置自动平移。但迁移默认值决定了今天的实际格局:启用过旧「Block AI」的域名,迁移后是 Search = Allow、Training = Disallow AI Training、Agent = Block on pages with ads。而 9 月 15 日之后新接入的域名,Cloudflare 对广告变现站点给出的推荐预设更严格:Training = Disallow AI Training、Agent = Block on pages with ads;不靠广告变现的站点两者默认 Allow。
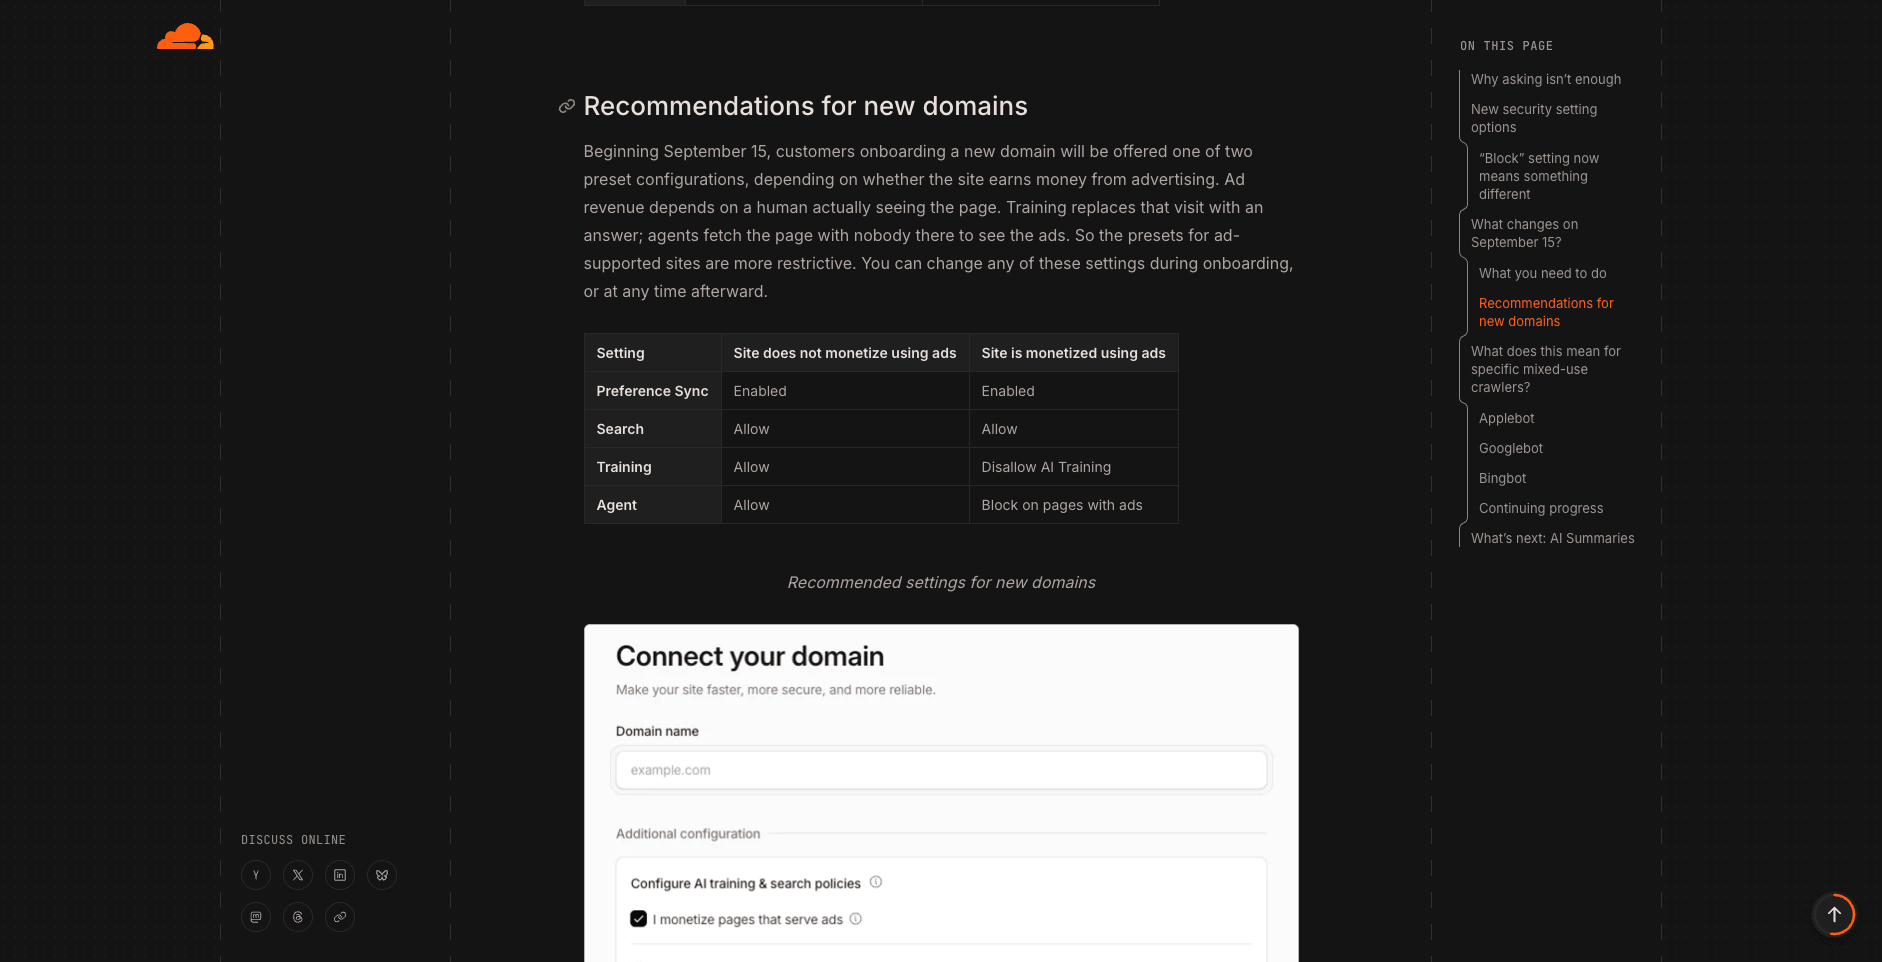
新域名推荐设置:广告变现站点默认 Disallow AI Training 和 Block on pages with ads(来源:Cloudflare Blog,访问于 2026-09-18)
Cloudflare 给出的采用数据解释了它为什么预期大多数站点会保持搜索开放:不到 1% 的 Cloudflare 站点封锁搜索爬虫,而 17% 已经在用某种机制阻止训练。搜索依然受欢迎,其他一切正变得越来越「有条件」。
两个时间线上的细节值得留意。第一,Bing 是慢的那一个:Microsoft 正在为「禁止训练」偏好构建 robots.txt 支持,目标 2027 年初——在那之前,站点的 Disallow AI Training 设置不会自动向 Bingbot 传达该偏好(站长可以先用 Bing 的 NOARCHIVE 标签或 URL 删除工具)。第二,Agent 类别暂时没有 Disallow 式设置——Cloudflare 表示,等 ai-prefs 之类的标准成熟后会重新评估。
为什么网页转 Markdown 的抓取首当其冲
下面这部分对提取工作流最关键,注意它是基于公告的分析,而不是官方政策本身:网页转 Markdown 工具不是 Search 爬虫,不是 Training 爬虫,也算不上严格的「受用户委托的 Agent」。当一个人把 URL 粘进工具要 Markdown 时,这次抓取在精神上是用户发起的——但一个通用的服务端抓取器,没有任何办法向一个实时做行为分类的网络证明这一点。
真正值得流水线维护者警惕的是默认值的方向。新接入的广告变现域名开箱即用 Agent = Block on pages with ads,迁移的存量「Block AI」域名也带着同样的 Agent 默认值,而投放广告的页面在商业互联网上无处不在。在这类域名上,一个看起来像「未分类 bot」的抓取器,恰恰会在那些最值得提取的页面上撞上验证或封锁。
关于执行方式也值得说精确。公告对 robots.txt 的态度很直白:仅凭一条指令,既不能识别谁在抓,也拦不住无视它的爬虫。Cloudflare 的答案是网络层的识别与执行,并在 Radar 上公开各家运营商的实际行为。换句话说,被评估的不是你的抓取器跳过了哪个文件,而是你的抓取器表现出的行为。
网页转 Markdown 工作流的调整做法
这不是说自动化提取没路可走,而是说粗放抓取的空间在收窄。五项调整覆盖大部分风险。
1. 诚实标识你的抓取器
按 User-Agent 分段,并保证字符串真实。像 Mozilla/5.0 (compatible; URL-to-Any/1.0) 这样的描述性 UA,能让站点运营方知道是谁在访问,从而主动决定放行还是拒绝。伪装浏览器 UA 这一周也许能多过几道门,但这是个持续性陷阱:分类系统给行为打分(抓取模式、脚本执行、请求头一致性),而不是只看 UA 字符串——非浏览器客户端顶着浏览器 UA,本身就是信号。整个 Accountable 框架奖励的是「报上名来」的运营方,你的抓取器应该成为其中一员。
2. 把 robots.txt 当作实时偏好源
Bot Preference Sync 意味着 robots.txt 现在承载机器发布、网络层护航的偏好——包括禁止训练指令。抓取前读一次 robots.txt 只多一个请求,却能告诉你这个站点如何对待自动化访问。对一次性的用户发起转换,和批量采集的考量理应不同;工作流应该把这个差异显式编码进去,而不是假装所有抓取都一样。
3. 提前设计失败降级路径
在一个持续收紧的网络里,403、托管质询、插页都是正常结果,不是 bug。健壮的流水线会识别它们(状态码加上针对验证页的内容嗅探),退避而不是猛冲,并向用户给出诚实的提示——「该站点阻止自动化抓取」——而不是把封锁页转换成垃圾 Markdown,悄悄污染下游数据。如果你的工具会明确报告抓取失败,那是功能,请把它当功能用。
4. 缓存与去重
同一个 URL 的每一次重复抓取,都会放大你在别人网络上的足迹。按内容寻址的缓存——以 URL 和内容哈希存储——能削减重复流量、降低延迟,也拉低了让无人值守抓取被标记的行为评分。
5. 按用途分段
如果你的系统既按计划监控页面、又服务交互式用户转换,把它们拆成不同的身份、执行不同的策略。定时监控不管叫什么名字看起来都像爬虫;交互式转换至少背后有一个真实用户。把两者混在一起,等于让面向用户的抓取继承批量任务的信誉。
今天就想转一个 URL?
如果是临时转换一次,选一个把关键事情做对的工具:诚实标识身份,失败时如实报告。URL to Any 的 URL to Markdown 工具在服务端抓取页面、把 HTML 转成干净的 Markdown,并用自己真实的 User-Agent 标识身份而非伪装浏览器——当站点拒绝抓取时,它会如实报告失败,而不是返回编造的内容。
想看转换本身的实操演示——输入选项、把结果交给 AI Agent、以及快速质量检查——请读姊妹篇《How to Convert a URL to Markdown for AI Agents》。
常见问题
Disallow AI Training 会影响我的搜索排名吗? 这正是公告的核心承诺:Apple、Google、Microsoft 均明确表示禁止训练不影响搜索排名,Cloudflare 的 Accountable 认定也是围绕这一保证建立的。
我的爬虫在 Cloudflare 防护的站点上是不是全废了? 不是一刀切。设置按域名生效,而且不到 1% 的 Cloudflare 站点封锁搜索爬虫。变化在于更严的默认值——尤其 Agent = Block on pages with ads——会成为常态,预期站点之间的差异更大、验证更频繁,并妥善处理它们。
Cloudflare 的政策能代表整个互联网吗? 不能。这些控制只覆盖 Cloudflare 防护的站点。其他网络和 CDN 有自己的规则——公告没有声称全行业跟进,你的可用性假设也不应该这么假设。
接下来会怎样? AI 摘要是公告指出的下一站:摘要退出权已是 Accountable 认定的要求,Cloudflare 计划在明年初让站长控制摘要中引用内容的多少。给摘要系统供数据的提取工作流,值得盯紧这次上线。
结语
互联网正在从「在 robots.txt 里礼貌请求」走向「细粒度、机器发布、网络层执行的偏好」。对网页转 Markdown 工作流来说,适配清单不长,但每条都实在:诚实标识、读偏好、缓存所抓、被拒时大声失败。做到这些,可用的那部分互联网依然向你敞开。
Related Articles
PDF 转 Markdown:LiteParse 9 月更新改变了什么
LiteParse 2.14.6 将 PDF 文本提取耗时缩短 20–25%,三个基准的表格准确率全面提升,并新增块级视觉定位与 is-complex 路由 API。解读这些厂商自报数据,并给出如何选择 PDF 转 Markdown 方案的决策标准。
Qwen3.8-Omni-Flash 上线:把网页转成 Markdown/JSON 喂给多模态模型
Qwen3.8-Omni-Flash 支持文本、图像、音频、视频输入与 1M 上下文,每小时音频输入价格下降超 98%。什么时候把网页转成 Markdown、什么时候转 JSON?浏览器免费完成,无需安装。
AI Agent 是怎么读网页的:Markdown 内容协商、WebMCP 与 10 秒自检
AI Agent 通过普通 HTTP 读取你的网页。讲清 Accept: text/markdown 内容协商的原理、哪些 Agent 真正支持、WebMCP 带来什么改变,以及如何 10 秒检查任意 URL。